6.2 해시 충돌
앞 절에서 설명했듯이 해시 함수의 입력 공간은 보통 출력 공간보다 훨씬 크므로, 이론적으로 해시 충돌은 피할 수 없다. 예를 들어 입력 공간이 모든 정수이고 출력 공간이 배열 용량만큼이라면, 여러 정수가 같은 버킷 인덱스에 매핑될 수밖에 없다.
해시 충돌은 잘못된 조회 결과를 일으켜 해시 테이블의 사용 가능성을 크게 해친다. 이를 해결하려면 충돌이 생길 때마다 해시 테이블을 확장하여 충돌이 없어질 때까지 반복할 수 있다. 단순하고 효과적인 방법이지만, 확장할 때 많은 데이터를 옮기고 해시값을 계산해야 하므로 효율은 매우 낮다. 효율을 높이려면 다음 전략을 사용할 수 있다.
- 해시 테이블의 자료 구조를 개선하여 해시 충돌이 발생해도 정상적으로 작동하게 한다.
- 필요한 경우, 즉 해시 충돌이 심할 때만 용량을 확장한다.
해시 테이블의 구조를 개선하는 대표적인 방법은 ‘체이닝’과 ‘개방 주소법’이다.
6.2.1 체이닝
기본 해시 테이블에서는 버킷 하나에 키-값 쌍 하나만 저장할 수 있다. 체이닝(separate chaining)은 단일 원소를 연결 리스트로 바꾸고, 키-값 쌍을 노드로 삼아 충돌한 키-값 쌍을 모두 같은 연결 리스트에 저장한다. 아래 그림(6-5)은 체이닝 해시 테이블의 예다.
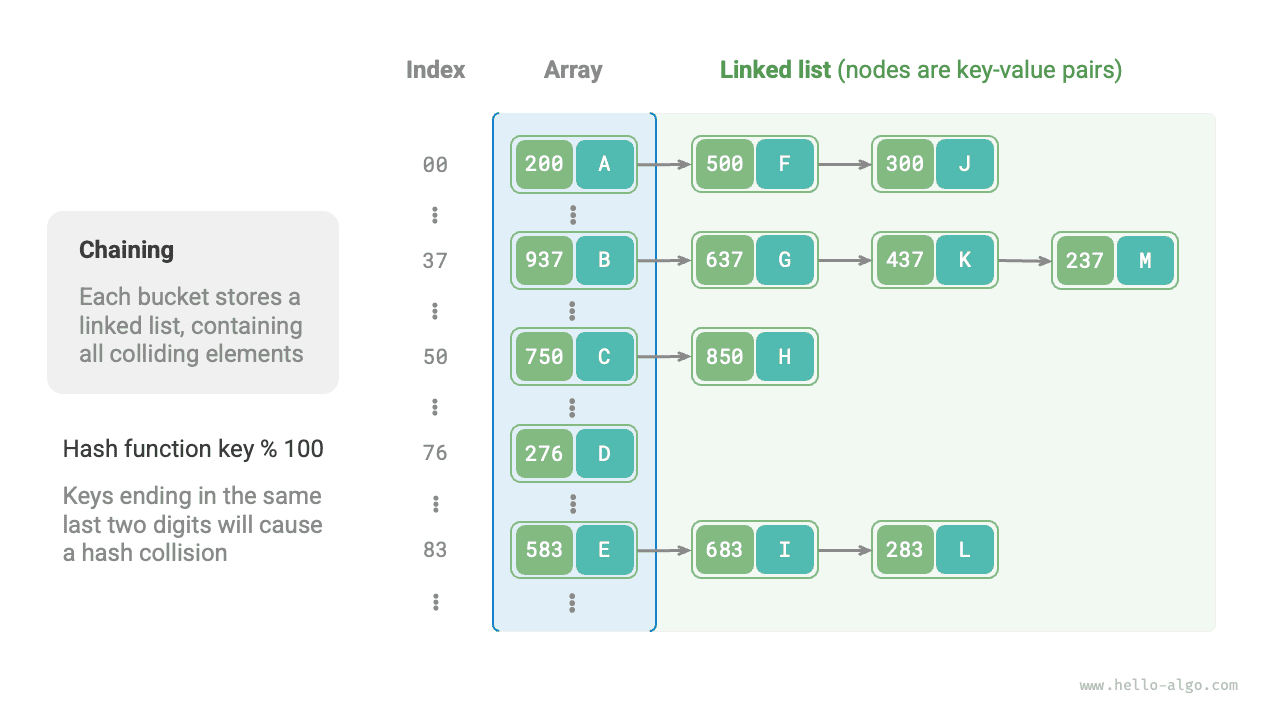
그림 6-5 체이닝 해시 테이블
체이닝 해시 테이블에서는 연산 방식이 다음과 같이 바뀐다.
- 원소 조회:
key를 입력하여 해시 함수로 버킷 인덱스를 구한 뒤 연결 리스트의 머리 노드에 접근한다. 이후 리스트를 순회하며key를 비교하여 목표 키-값 쌍을 찾는다. - 원소 추가: 해시 함수로 연결 리스트의 머리 노드에 접근한 뒤, 노드(키-값 쌍)를 리스트에 추가한다.
- 원소 삭제: 해시 함수의 결과로 연결 리스트의 맨 앞에 접근한 뒤, 순회하여 목표 노드를 찾아 삭제한다.
체이닝에는 다음과 같은 한계가 있다.
- 공간 사용량 증가: 연결 리스트에는 노드 포인터가 있으므로 배열보다 메모리를 더 많이 사용한다.
- 조회 효율 감소: 해당 원소를 찾으려면 연결 리스트를 선형으로 순회해야 한다.
다음 코드는 간단한 체이닝 해시 테이블을 구현한다. 두 가지에 주의하자.
- 코드를 단순화하기 위해 연결 리스트 대신 리스트(동적 배열)를 사용한다. 따라서 해시 테이블(배열)은 여러 버킷을 포함하며, 각 버킷은 리스트다.
- 아래 구현에는 용량 확장 메서드가 포함된다. 적재율이 \(\frac{2}{3}\)를 넘으면 해시 테이블을 기존 크기의 \(2\)배로 늘린다.
class HashMapChaining:
    """체이닝 해시 테이블"""

    def __init__(self):
        """생성자"""
        self.size = 0  # 키-값 쌍 개수
        self.capacity = 4  # 해시 테이블 용량
        self.load_thres = 2.0 / 3.0  # 용량 확장을 수행하는 적재율 임계값
        self.extend_ratio = 2  # 용량 확장 배수
        self.buckets = [[] for _ in range(self.capacity)]  # 버킷 배열

    def hash_func(self, key: int) -> int:
        """해시 함수"""
        return key % self.capacity

    def load_factor(self) -> float:
        """적재율"""
        return self.size / self.capacity

    def get(self, key: int) -> str | None:
        """조회 연산"""
        index = self.hash_func(key)
        bucket = self.buckets[index]
        # 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for pair in bucket:
            if pair.key == key:
                return pair.val
        # key를 찾지 못하면 None을 반환한다
        return None

    def put(self, key: int, val: str):
        """추가 연산"""
        # 적재율이 임계값을 초과하면 용량을 확장한다
        if self.load_factor() > self.load_thres:
            self.extend()
        index = self.hash_func(key)
        bucket = self.buckets[index]
        # 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for pair in bucket:
            if pair.key == key:
                pair.val = val
                return
        # 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        pair = Pair(key, val)
        bucket.append(pair)
        self.size += 1

    def remove(self, key: int):
        """삭제 연산"""
        index = self.hash_func(key)
        bucket = self.buckets[index]
        # 버킷을 순회하며 키-값 쌍을 삭제한다
        for pair in bucket:
            if pair.key == key:
                bucket.remove(pair)
                self.size -= 1
                break

    def extend(self):
        """해시 테이블 용량 확장"""
        # 원래 해시 테이블을 임시로 저장한다
        buckets = self.buckets
        # 용량을 확장한 새 해시 테이블을 초기화한다
        self.capacity *= self.extend_ratio
        self.buckets = [[] for _ in range(self.capacity)]
        self.size = 0
        # 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for bucket in buckets:
            for pair in bucket:
                self.put(pair.key, pair.val)

    def print(self):
        """해시 테이블 출력"""
        for bucket in self.buckets:
            res = []
            for pair in bucket:
                res.append(str(pair.key) + " -> " + pair.val)
            print(res)
/* 체이닝 해시 테이블 */
class HashMapChaining {
  private:
    int size;                       // 키-값 쌍 개수
    int capacity;                   // 해시 테이블 용량
    double loadThres;               // 용량 확장을 수행하는 적재율 임계값
    int extendRatio;                // 용량 확장 배수
    vector<vector<Pair *>> buckets; // 버킷 배열

  public:
    /* 생성자 */
    HashMapChaining() : size(0), capacity(4), loadThres(2.0 / 3.0), extendRatio(2) {
        buckets.resize(capacity);
    }

    /* 소멸자 */
    ~HashMapChaining() {
        for (auto &bucket : buckets) {
            for (Pair *pair : bucket) {
                // 메모리 해제
                delete pair;
            }
        }
    }

    /* 해시 함수 */
    int hashFunc(int key) {
        return key % capacity;
    }

    /* 적재율 */
    double loadFactor() {
        return (double)size / (double)capacity;
    }

    /* 조회 연산 */
    string get(int key) {
        int index = hashFunc(key);
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for (Pair *pair : buckets[index]) {
            if (pair->key == key) {
                return pair->val;
            }
        }
        // key를 찾지 못하면 빈 문자열을 반환한다
        return "";
    }

    /* 추가 연산 */
    void put(int key, string val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (loadFactor() > loadThres) {
            extend();
        }
        int index = hashFunc(key);
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for (Pair *pair : buckets[index]) {
            if (pair->key == key) {
                pair->val = val;
                return;
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        buckets[index].push_back(new Pair(key, val));
        size++;
    }

    /* 삭제 연산 */
    void remove(int key) {
        int index = hashFunc(key);
        auto &bucket = buckets[index];
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (int i = 0; i < bucket.size(); i++) {
            if (bucket[i]->key == key) {
                Pair *tmp = bucket[i];
                bucket.erase(bucket.begin() + i); // 해당 키-값 쌍을 삭제한다
                delete tmp;                       // 메모리 해제
                size--;
                return;
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    void extend() {
        // 원래 해시 테이블을 임시로 저장한다
        vector<vector<Pair *>> bucketsTmp = buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio;
        buckets.clear();
        buckets.resize(capacity);
        size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (auto &bucket : bucketsTmp) {
            for (Pair *pair : bucket) {
                put(pair->key, pair->val);
                // 메모리 해제
                delete pair;
            }
        }
    }

    /* 해시 테이블 출력 */
    void print() {
        for (auto &bucket : buckets) {
            cout << "[";
            for (Pair *pair : bucket) {
                cout << pair->key << " -> " << pair->val << ", ";
            }
            cout << "]\n";
        }
    }
};
/* 체이닝 해시 테이블 */
class HashMapChaining {
    int size; // 키-값 쌍 개수
    int capacity; // 해시 테이블 용량
    double loadThres; // 용량 확장을 수행하는 적재율 임계값
    int extendRatio; // 용량 확장 배수
    List<List<Pair>> buckets; // 버킷 배열

    /* 생성자 */
    public HashMapChaining() {
        size = 0;
        capacity = 4;
        loadThres = 2.0 / 3.0;
        extendRatio = 2;
        buckets = new ArrayList<>(capacity);
        for (int i = 0; i < capacity; i++) {
            buckets.add(new ArrayList<>());
        }
    }

    /* 해시 함수 */
    int hashFunc(int key) {
        return key % capacity;
    }

    /* 적재율 */
    double loadFactor() {
        return (double) size / capacity;
    }

    /* 조회 연산 */
    String get(int key) {
        int index = hashFunc(key);
        List<Pair> bucket = buckets.get(index);
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for (Pair pair : bucket) {
            if (pair.key == key) {
                return pair.val;
            }
        }
        // key를 찾지 못하면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    void put(int key, String val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (loadFactor() > loadThres) {
            extend();
        }
        int index = hashFunc(key);
        List<Pair> bucket = buckets.get(index);
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for (Pair pair : bucket) {
            if (pair.key == key) {
                pair.val = val;
                return;
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        Pair pair = new Pair(key, val);
        bucket.add(pair);
        size++;
    }

    /* 삭제 연산 */
    void remove(int key) {
        int index = hashFunc(key);
        List<Pair> bucket = buckets.get(index);
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (Pair pair : bucket) {
            if (pair.key == key) {
                bucket.remove(pair);
                size--;
                break;
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    void extend() {
        // 원래 해시 테이블을 임시로 저장한다
        List<List<Pair>> bucketsTmp = buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio;
        buckets = new ArrayList<>(capacity);
        for (int i = 0; i < capacity; i++) {
            buckets.add(new ArrayList<>());
        }
        size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (List<Pair> bucket : bucketsTmp) {
            for (Pair pair : bucket) {
                put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    void print() {
        for (List<Pair> bucket : buckets) {
            List<String> res = new ArrayList<>();
            for (Pair pair : bucket) {
                res.add(pair.key + " -> " + pair.val);
            }
            System.out.println(res);
        }
    }
}
/* 체이닝 해시 테이블 */
class HashMapChaining {
    int size; // 키-값 쌍 개수
    int capacity; // 해시 테이블 용량
    double loadThres; // 용량 확장을 수행하는 적재율 임계값
    int extendRatio; // 용량 확장 배수
    List<List<Pair>> buckets; // 버킷 배열

    /* 생성자 */
    public HashMapChaining() {
        size = 0;
        capacity = 4;
        loadThres = 2.0 / 3.0;
        extendRatio = 2;
        buckets = new List<List<Pair>>(capacity);
        for (int i = 0; i < capacity; i++) {
            buckets.Add([]);
        }
    }

    /* 해시 함수 */
    int HashFunc(int key) {
        return key % capacity;
    }

    /* 적재율 */
    double LoadFactor() {
        return (double)size / capacity;
    }

    /* 조회 연산 */
    public string? Get(int key) {
        int index = HashFunc(key);
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        foreach (Pair pair in buckets[index]) {
            if (pair.key == key) {
                return pair.val;
            }
        }
        // key를 찾지 못하면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    public void Put(int key, string val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (LoadFactor() > loadThres) {
            Extend();
        }
        int index = HashFunc(key);
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        foreach (Pair pair in buckets[index]) {
            if (pair.key == key) {
                pair.val = val;
                return;
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        buckets[index].Add(new Pair(key, val));
        size++;
    }

    /* 삭제 연산 */
    public void Remove(int key) {
        int index = HashFunc(key);
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        foreach (Pair pair in buckets[index].ToList()) {
            if (pair.key == key) {
                buckets[index].Remove(pair);
                size--;
                break;
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    void Extend() {
        // 원래 해시 테이블을 임시로 저장한다
        List<List<Pair>> bucketsTmp = buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio;
        buckets = new List<List<Pair>>(capacity);
        for (int i = 0; i < capacity; i++) {
            buckets.Add([]);
        }
        size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        foreach (List<Pair> bucket in bucketsTmp) {
            foreach (Pair pair in bucket) {
                Put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    public void Print() {
        foreach (List<Pair> bucket in buckets) {
            List<string> res = [];
            foreach (Pair pair in bucket) {
                res.Add(pair.key + " -> " + pair.val);
            }
            foreach (string kv in res) {
                Console.WriteLine(kv);
            }
        }
    }
}
/* 체이닝 해시 테이블 */
type hashMapChaining struct {
    size        int      // 키-값 쌍 개수
    capacity    int      // 해시 테이블 용량
    loadThres   float64  // 용량 확장을 수행하는 적재율 임계값
    extendRatio int      // 용량 확장 배수
    buckets     [][]pair // 버킷 배열
}

/* 생성자 */
func newHashMapChaining() *hashMapChaining {
    buckets := make([][]pair, 4)
    for i := 0; i < 4; i++ {
        buckets[i] = make([]pair, 0)
    }
    return &hashMapChaining{
        size:        0,
        capacity:    4,
        loadThres:   2.0 / 3.0,
        extendRatio: 2,
        buckets:     buckets,
    }
}

/* 해시 함수 */
func (m *hashMapChaining) hashFunc(key int) int {
    return key % m.capacity
}

/* 적재율 */
func (m *hashMapChaining) loadFactor() float64 {
    return float64(m.size) / float64(m.capacity)
}

/* 조회 연산 */
func (m *hashMapChaining) get(key int) string {
    idx := m.hashFunc(key)
    bucket := m.buckets[idx]
    // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
    for _, p := range bucket {
        if p.key == key {
            return p.val
        }
    }
    // key를 찾지 못하면 빈 문자열을 반환한다
    return ""
}

/* 추가 연산 */
func (m *hashMapChaining) put(key int, val string) {
    // 적재율이 임계값을 초과하면 용량을 확장한다
    if m.loadFactor() > m.loadThres {
        m.extend()
    }
    idx := m.hashFunc(key)
    // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
    for i := range m.buckets[idx] {
        if m.buckets[idx][i].key == key {
            m.buckets[idx][i].val = val
            return
        }
    }
    // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
    p := pair{
        key: key,
        val: val,
    }
    m.buckets[idx] = append(m.buckets[idx], p)
    m.size += 1
}

/* 삭제 연산 */
func (m *hashMapChaining) remove(key int) {
    idx := m.hashFunc(key)
    // 버킷을 순회하며 키-값 쌍을 삭제한다
    for i, p := range m.buckets[idx] {
        if p.key == key {
            // 슬라이스에서 삭제한다
            m.buckets[idx] = append(m.buckets[idx][:i], m.buckets[idx][i+1:]...)
            m.size -= 1
            break
        }
    }
}

/* 해시 테이블 용량 확장 */
func (m *hashMapChaining) extend() {
    // 원래 해시 테이블을 임시로 저장한다
    tmpBuckets := make([][]pair, len(m.buckets))
    for i := 0; i < len(m.buckets); i++ {
        tmpBuckets[i] = make([]pair, len(m.buckets[i]))
        copy(tmpBuckets[i], m.buckets[i])
    }
    // 용량을 확장한 새 해시 테이블을 초기화한다
    m.capacity *= m.extendRatio
    m.buckets = make([][]pair, m.capacity)
    for i := 0; i < m.capacity; i++ {
        m.buckets[i] = make([]pair, 0)
    }
    m.size = 0
    // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for _, bucket := range tmpBuckets {
        for _, p := range bucket {
            m.put(p.key, p.val)
        }
    }
}

/* 해시 테이블 출력 */
func (m *hashMapChaining) print() {
    var builder strings.Builder

    for _, bucket := range m.buckets {
        builder.WriteString("[")
        for _, p := range bucket {
            builder.WriteString(strconv.Itoa(p.key) + " -> " + p.val + " ")
        }
        builder.WriteString("]")
        fmt.Println(builder.String())
        builder.Reset()
    }
}
/* 체이닝 해시 테이블 */
class HashMapChaining {
    var size: Int // 키-값 쌍 개수
    var capacity: Int // 해시 테이블 용량
    var loadThres: Double // 용량 확장을 수행하는 적재율 임계값
    var extendRatio: Int // 용량 확장 배수
    var buckets: [[Pair]] // 버킷 배열

    /* 생성자 */
    init() {
        size = 0
        capacity = 4
        loadThres = 2.0 / 3.0
        extendRatio = 2
        buckets = Array(repeating: [], count: capacity)
    }

    /* 해시 함수 */
    func hashFunc(key: Int) -> Int {
        key % capacity
    }

    /* 적재율 */
    func loadFactor() -> Double {
        Double(size) / Double(capacity)
    }

    /* 조회 연산 */
    func get(key: Int) -> String? {
        let index = hashFunc(key: key)
        let bucket = buckets[index]
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for pair in bucket {
            if pair.key == key {
                return pair.val
            }
        }
        // key를 찾지 못하면 nil을 반환한다
        return nil
    }

    /* 추가 연산 */
    func put(key: Int, val: String) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if loadFactor() > loadThres {
            extend()
        }
        let index = hashFunc(key: key)
        let bucket = buckets[index]
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for pair in bucket {
            if pair.key == key {
                pair.val = val
                return
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        let pair = Pair(key: key, val: val)
        buckets[index].append(pair)
        size += 1
    }

    /* 삭제 연산 */
    func remove(key: Int) {
        let index = hashFunc(key: key)
        let bucket = buckets[index]
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (pairIndex, pair) in bucket.enumerated() {
            if pair.key == key {
                buckets[index].remove(at: pairIndex)
                size -= 1
                break
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    func extend() {
        // 원래 해시 테이블을 임시로 저장한다
        let bucketsTmp = buckets
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio
        buckets = Array(repeating: [], count: capacity)
        size = 0
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for bucket in bucketsTmp {
            for pair in bucket {
                put(key: pair.key, val: pair.val)
            }
        }
    }

    /* 해시 테이블 출력 */
    func print() {
        for bucket in buckets {
            let res = bucket.map { "\($0.key) -> \($0.val)" }
            Swift.print(res)
        }
    }
}
/* 체이닝 해시 테이블 */
class HashMapChaining {
    #size; // 키-값 쌍 개수
    #capacity; // 해시 테이블 용량
    #loadThres; // 용량 확장을 수행하는 적재율 임계값
    #extendRatio; // 용량 확장 배수
    #buckets; // 버킷 배열

    /* 생성자 */
    constructor() {
        this.#size = 0;
        this.#capacity = 4;
        this.#loadThres = 2.0 / 3.0;
        this.#extendRatio = 2;
        this.#buckets = new Array(this.#capacity).fill(null).map((x) => []);
    }

    /* 해시 함수 */
    #hashFunc(key) {
        return key % this.#capacity;
    }

    /* 적재율 */
    #loadFactor() {
        return this.#size / this.#capacity;
    }

    /* 조회 연산 */
    get(key) {
        const index = this.#hashFunc(key);
        const bucket = this.#buckets[index];
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for (const pair of bucket) {
            if (pair.key === key) {
                return pair.val;
            }
        }
        // key를 찾지 못하면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    put(key, val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (this.#loadFactor() > this.#loadThres) {
            this.#extend();
        }
        const index = this.#hashFunc(key);
        const bucket = this.#buckets[index];
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for (const pair of bucket) {
            if (pair.key === key) {
                pair.val = val;
                return;
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        const pair = new Pair(key, val);
        bucket.push(pair);
        this.#size++;
    }

    /* 삭제 연산 */
    remove(key) {
        const index = this.#hashFunc(key);
        let bucket = this.#buckets[index];
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (let i = 0; i < bucket.length; i++) {
            if (bucket[i].key === key) {
                bucket.splice(i, 1);
                this.#size--;
                break;
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    #extend() {
        // 원래 해시 테이블을 임시로 저장한다
        const bucketsTmp = this.#buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        this.#capacity *= this.#extendRatio;
        this.#buckets = new Array(this.#capacity).fill(null).map((x) => []);
        this.#size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (const bucket of bucketsTmp) {
            for (const pair of bucket) {
                this.put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    print() {
        for (const bucket of this.#buckets) {
            let res = [];
            for (const pair of bucket) {
                res.push(pair.key + ' -> ' + pair.val);
            }
            console.log(res);
        }
    }
}
/* 체이닝 해시 테이블 */
class HashMapChaining {
    #size: number; // 키-값 쌍 개수
    #capacity: number; // 해시 테이블 용량
    #loadThres: number; // 용량 확장을 수행하는 적재율 임계값
    #extendRatio: number; // 용량 확장 배수
    #buckets: Pair[][]; // 버킷 배열

    /* 생성자 */
    constructor() {
        this.#size = 0;
        this.#capacity = 4;
        this.#loadThres = 2.0 / 3.0;
        this.#extendRatio = 2;
        this.#buckets = new Array(this.#capacity).fill(null).map((x) => []);
    }

    /* 해시 함수 */
    #hashFunc(key: number): number {
        return key % this.#capacity;
    }

    /* 적재율 */
    #loadFactor(): number {
        return this.#size / this.#capacity;
    }

    /* 조회 연산 */
    get(key: number): string | null {
        const index = this.#hashFunc(key);
        const bucket = this.#buckets[index];
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for (const pair of bucket) {
            if (pair.key === key) {
                return pair.val;
            }
        }
        // key를 찾지 못하면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    put(key: number, val: string): void {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (this.#loadFactor() > this.#loadThres) {
            this.#extend();
        }
        const index = this.#hashFunc(key);
        const bucket = this.#buckets[index];
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for (const pair of bucket) {
            if (pair.key === key) {
                pair.val = val;
                return;
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        const pair = new Pair(key, val);
        bucket.push(pair);
        this.#size++;
    }

    /* 삭제 연산 */
    remove(key: number): void {
        const index = this.#hashFunc(key);
        let bucket = this.#buckets[index];
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (let i = 0; i < bucket.length; i++) {
            if (bucket[i].key === key) {
                bucket.splice(i, 1);
                this.#size--;
                break;
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    #extend(): void {
        // 원래 해시 테이블을 임시로 저장한다
        const bucketsTmp = this.#buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        this.#capacity *= this.#extendRatio;
        this.#buckets = new Array(this.#capacity).fill(null).map((x) => []);
        this.#size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (const bucket of bucketsTmp) {
            for (const pair of bucket) {
                this.put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    print(): void {
        for (const bucket of this.#buckets) {
            let res = [];
            for (const pair of bucket) {
                res.push(pair.key + ' -> ' + pair.val);
            }
            console.log(res);
        }
    }
}
/* 체이닝 해시 테이블 */
class HashMapChaining {
  late int size; // 키-값 쌍 개수
  late int capacity; // 해시 테이블 용량
  late double loadThres; // 용량 확장을 수행하는 적재율 임계값
  late int extendRatio; // 용량 확장 배수
  late List<List<Pair>> buckets; // 버킷 배열

  /* 생성자 */
  HashMapChaining() {
    size = 0;
    capacity = 4;
    loadThres = 2.0 / 3.0;
    extendRatio = 2;
    buckets = List.generate(capacity, (_) => []);
  }

  /* 해시 함수 */
  int hashFunc(int key) {
    return key % capacity;
  }

  /* 적재율 */
  double loadFactor() {
    return size / capacity;
  }

  /* 조회 연산 */
  String? get(int key) {
    int index = hashFunc(key);
    List<Pair> bucket = buckets[index];
    // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
    for (Pair pair in bucket) {
      if (pair.key == key) {
        return pair.val;
      }
    }
    // key를 찾지 못하면 null을 반환한다
    return null;
  }

  /* 추가 연산 */
  void put(int key, String val) {
    // 적재율이 임계값을 초과하면 용량을 확장한다
    if (loadFactor() > loadThres) {
      extend();
    }
    int index = hashFunc(key);
    List<Pair> bucket = buckets[index];
    // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
    for (Pair pair in bucket) {
      if (pair.key == key) {
        pair.val = val;
        return;
      }
    }
    // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
    Pair pair = Pair(key, val);
    bucket.add(pair);
    size++;
  }

  /* 삭제 연산 */
  void remove(int key) {
    int index = hashFunc(key);
    List<Pair> bucket = buckets[index];
    // 버킷을 순회하며 키-값 쌍을 삭제한다
    for (Pair pair in bucket) {
      if (pair.key == key) {
        bucket.remove(pair);
        size--;
        break;
      }
    }
  }

  /* 해시 테이블 용량 확장 */
  void extend() {
    // 원래 해시 테이블을 임시로 저장한다
    List<List<Pair>> bucketsTmp = buckets;
    // 용량을 확장한 새 해시 테이블을 초기화한다
    capacity *= extendRatio;
    buckets = List.generate(capacity, (_) => []);
    size = 0;
    // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for (List<Pair> bucket in bucketsTmp) {
      for (Pair pair in bucket) {
        put(pair.key, pair.val);
      }
    }
  }

  /* 해시 테이블 출력 */
  void printHashMap() {
    for (List<Pair> bucket in buckets) {
      List<String> res = [];
      for (Pair pair in bucket) {
        res.add("${pair.key} -> ${pair.val}");
      }
      print(res);
    }
  }
}
/* 체이닝 해시 테이블 */
struct HashMapChaining {
    size: usize,
    capacity: usize,
    load_thres: f32,
    extend_ratio: usize,
    buckets: Vec<Vec<Pair>>,
}

impl HashMapChaining {
    /* 생성자 */
    fn new() -> Self {
        Self {
            size: 0,
            capacity: 4,
            load_thres: 2.0 / 3.0,
            extend_ratio: 2,
            buckets: vec![vec![]; 4],
        }
    }

    /* 해시 함수 */
    fn hash_func(&self, key: i32) -> usize {
        key as usize % self.capacity
    }

    /* 적재율 */
    fn load_factor(&self) -> f32 {
        self.size as f32 / self.capacity as f32
    }

    /* 삭제 연산 */
    fn remove(&mut self, key: i32) -> Option<String> {
        let index = self.hash_func(key);

        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (i, p) in self.buckets[index].iter_mut().enumerate() {
            if p.key == key {
                let pair = self.buckets[index].remove(i);
                self.size -= 1;
                return Some(pair.val);
            }
        }

        // key를 찾지 못하면 None을 반환한다
        None
    }

    /* 해시 테이블 용량 확장 */
    fn extend(&mut self) {
        // 원래 해시 테이블을 임시로 저장한다
        let buckets_tmp = std::mem::take(&mut self.buckets);

        // 용량을 확장한 새 해시 테이블을 초기화한다
        self.capacity *= self.extend_ratio;
        self.buckets = vec![Vec::new(); self.capacity as usize];
        self.size = 0;

        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for bucket in buckets_tmp {
            for pair in bucket {
                self.put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    fn print(&self) {
        for bucket in &self.buckets {
            let mut res = Vec::new();
            for pair in bucket {
                res.push(format!("{} -> {}", pair.key, pair.val));
            }
            println!("{:?}", res);
        }
    }

    /* 추가 연산 */
    fn put(&mut self, key: i32, val: String) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if self.load_factor() > self.load_thres {
            self.extend();
        }

        let index = self.hash_func(key);

        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for pair in self.buckets[index].iter_mut() {
            if pair.key == key {
                pair.val = val;
                return;
            }
        }

        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        let pair = Pair { key, val };
        self.buckets[index].push(pair);
        self.size += 1;
    }

    /* 조회 연산 */
    fn get(&self, key: i32) -> Option<&str> {
        let index = self.hash_func(key);

        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for pair in self.buckets[index].iter() {
            if pair.key == key {
                return Some(&pair.val);
            }
        }

        // key를 찾지 못하면 None을 반환한다
        None
    }
}
/* 연결 리스트 노드 */
typedef struct Node {
    Pair *pair;
    struct Node *next;
} Node;

/* 체이닝 해시 테이블 */
typedef struct {
    int size;         // 키-값 쌍 개수
    int capacity;     // 해시 테이블 용량
    double loadThres; // 용량 확장을 수행하는 적재율 임계값
    int extendRatio;  // 용량 확장 배수
    Node **buckets;   // 버킷 배열
} HashMapChaining;

/* 생성자 */
HashMapChaining *newHashMapChaining() {
    HashMapChaining *hashMap = (HashMapChaining *)malloc(sizeof(HashMapChaining));
    hashMap->size = 0;
    hashMap->capacity = 4;
    hashMap->loadThres = 2.0 / 3.0;
    hashMap->extendRatio = 2;
    hashMap->buckets = (Node **)malloc(hashMap->capacity * sizeof(Node *));
    for (int i = 0; i < hashMap->capacity; i++) {
        hashMap->buckets[i] = NULL;
    }
    return hashMap;
}

/* 소멸자 */
void delHashMapChaining(HashMapChaining *hashMap) {
    for (int i = 0; i < hashMap->capacity; i++) {
        Node *cur = hashMap->buckets[i];
        while (cur) {
            Node *tmp = cur;
            cur = cur->next;
            free(tmp->pair);
            free(tmp);
        }
    }
    free(hashMap->buckets);
    free(hashMap);
}

/* 해시 함수 */
int hashFunc(HashMapChaining *hashMap, int key) {
    return key % hashMap->capacity;
}

/* 적재율 */
double loadFactor(HashMapChaining *hashMap) {
    return (double)hashMap->size / (double)hashMap->capacity;
}

/* 조회 연산 */
char *get(HashMapChaining *hashMap, int key) {
    int index = hashFunc(hashMap, key);
    // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
    Node *cur = hashMap->buckets[index];
    while (cur) {
        if (cur->pair->key == key) {
            return cur->pair->val;
        }
        cur = cur->next;
    }
    return ""; // key를 찾지 못하면 빈 문자열을 반환한다
}

/* 추가 연산 */
void put(HashMapChaining *hashMap, int key, const char *val) {
    // 적재율이 임계값을 초과하면 용량을 확장한다
    if (loadFactor(hashMap) > hashMap->loadThres) {
        extend(hashMap);
    }
    int index = hashFunc(hashMap, key);
    // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
    Node *cur = hashMap->buckets[index];
    while (cur) {
        if (cur->pair->key == key) {
            strcpy(cur->pair->val, val); // 지정한 key를 만나면 해당 val을 갱신하고 반환한다
            return;
        }
        cur = cur->next;
    }
    // 해당 key가 없으면 키-값 쌍을 연결 리스트의 맨 앞에 추가한다
    Pair *newPair = (Pair *)malloc(sizeof(Pair));
    newPair->key = key;
    strcpy(newPair->val, val);
    Node *newNode = (Node *)malloc(sizeof(Node));
    newNode->pair = newPair;
    newNode->next = hashMap->buckets[index];
    hashMap->buckets[index] = newNode;
    hashMap->size++;
}

/* 해시 테이블 용량 확장 */
void extend(HashMapChaining *hashMap) {
    // 원래 해시 테이블을 임시로 저장한다
    int oldCapacity = hashMap->capacity;
    Node **oldBuckets = hashMap->buckets;
    // 용량을 확장한 새 해시 테이블을 초기화한다
    hashMap->capacity *= hashMap->extendRatio;
    hashMap->buckets = (Node **)malloc(hashMap->capacity * sizeof(Node *));
    for (int i = 0; i < hashMap->capacity; i++) {
        hashMap->buckets[i] = NULL;
    }
    hashMap->size = 0;
    // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for (int i = 0; i < oldCapacity; i++) {
        Node *cur = oldBuckets[i];
        while (cur) {
            put(hashMap, cur->pair->key, cur->pair->val);
            Node *temp = cur;
            cur = cur->next;
            // 메모리 해제
            free(temp->pair);
            free(temp);
        }
    }

    free(oldBuckets);
}

/* 삭제 연산 */
void removeItem(HashMapChaining *hashMap, int key) {
    int index = hashFunc(hashMap, key);
    Node *cur = hashMap->buckets[index];
    Node *pre = NULL;
    while (cur) {
        if (cur->pair->key == key) {
            // 해당 키-값 쌍을 삭제한다
            if (pre) {
                pre->next = cur->next;
            } else {
                hashMap->buckets[index] = cur->next;
            }
            // 메모리 해제
            free(cur->pair);
            free(cur);
            hashMap->size--;
            return;
        }
        pre = cur;
        cur = cur->next;
    }
}

/* 해시 테이블 출력 */
void print(HashMapChaining *hashMap) {
    for (int i = 0; i < hashMap->capacity; i++) {
        Node *cur = hashMap->buckets[i];
        printf("[");
        while (cur) {
            printf("%d -> %s, ", cur->pair->key, cur->pair->val);
            cur = cur->next;
        }
        printf("]\n");
    }
}
/* 체이닝 해시 테이블 */
class HashMapChaining {
    var size: Int // 키-값 쌍 개수
    var capacity: Int // 해시 테이블 용량
    val loadThres: Double // 용량 확장을 수행하는 적재율 임계값
    val extendRatio: Int // 용량 확장 배수
    var buckets: MutableList<MutableList<Pair>> // 버킷 배열

    /* 생성자 */
    init {
        size = 0
        capacity = 4
        loadThres = 2.0 / 3.0
        extendRatio = 2
        buckets = mutableListOf()
        for (i in 0..<capacity) {
            buckets.add(mutableListOf())
        }
    }

    /* 해시 함수 */
    fun hashFunc(key: Int): Int {
        return key % capacity
    }

    /* 적재율 */
    fun loadFactor(): Double {
        return (size / capacity).toDouble()
    }

    /* 조회 연산 */
    fun get(key: Int): String? {
        val index = hashFunc(key)
        val bucket = buckets[index]
        // 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
        for (pair in bucket) {
            if (pair.key == key) return pair._val
        }
        // key를 찾지 못하면 null을 반환한다
        return null
    }

    /* 추가 연산 */
    fun put(key: Int, _val: String) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (loadFactor() > loadThres) {
            extend()
        }
        val index = hashFunc(key)
        val bucket = buckets[index]
        // 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
        for (pair in bucket) {
            if (pair.key == key) {
                pair._val = _val
                return
            }
        }
        // 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
        val pair = Pair(key, _val)
        bucket.add(pair)
        size++
    }

    /* 삭제 연산 */
    fun remove(key: Int) {
        val index = hashFunc(key)
        val bucket = buckets[index]
        // 버킷을 순회하며 키-값 쌍을 삭제한다
        for (pair in bucket) {
            if (pair.key == key) {
                bucket.remove(pair)
                size--
                break
            }
        }
    }

    /* 해시 테이블 용량 확장 */
    fun extend() {
        // 원래 해시 테이블을 임시로 저장한다
        val bucketsTmp = buckets
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio
        // mutablelist는 크기가 고정되어 있지 않다
        buckets = mutableListOf()
        for (i in 0..<capacity) {
            buckets.add(mutableListOf())
        }
        size = 0
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (bucket in bucketsTmp) {
            for (pair in bucket) {
                put(pair.key, pair._val)
            }
        }
    }

    /* 해시 테이블 출력 */
    fun print() {
        for (bucket in buckets) {
            val res = mutableListOf<String>()
            for (pair in bucket) {
                val k = pair.key
                val v = pair._val
                res.add("$k -> $v")
            }
            println(res)
        }
    }
}
### 체이닝 해시 테이블 ###
class HashMapChaining
  ### 생성자 ###
  def initialize
    @size = 0 # 키-값 쌍 개수
    @capacity = 4 # 해시 테이블 용량
    @load_thres = 2.0 / 3.0 # 용량 확장을 수행하는 적재율 임계값
    @extend_ratio = 2 # 용량 확장 배수
    @buckets = Array.new(@capacity) { [] } # 버킷 배열
  end

  ### 해시 함수 ###
  def hash_func(key)
    key % @capacity
  end

  ### 적재율 ###
  def load_factor
    @size / @capacity
  end

  ### 조회 연산 ###
  def get(key)
    index = hash_func(key)
    bucket = @buckets[index]
    # 버킷을 순회하다 key를 찾으면 해당 val을 반환한다
    for pair in bucket
      return pair.val if pair.key == key
    end
    # key를 찾지 못하면 nil을 반환한다
    nil
  end

  ### 추가 연산 ###
  def put(key, val)
    # 적재율이 임계값을 초과하면 용량을 확장한다
    extend if load_factor > @load_thres
    index = hash_func(key)
    bucket = @buckets[index]
    # 버킷을 순회하다 지정한 key를 만나면 해당 val을 갱신하고 반환한다
    for pair in bucket
      if pair.key == key
        pair.val = val
        return
      end
    end
    # 해당 key가 없으면 키-값 쌍을 맨 뒤에 추가한다
    pair = Pair.new(key, val)
    bucket << pair
    @size += 1
  end

  ### 삭제 연산 ###
  def remove(key)
    index = hash_func(key)
    bucket = @buckets[index]
    # 버킷을 순회하며 키-값 쌍을 삭제한다
    for pair in bucket
      if pair.key == key
        bucket.delete(pair)
        @size -= 1
        break
      end
    end
  end

  ### 해시 테이블 용량 확장 ###
  def extend
    # 원래 해시 테이블을 임시로 저장한다
    buckets = @buckets
    # 용량을 확장한 새 해시 테이블을 초기화한다
    @capacity *= @extend_ratio
    @buckets = Array.new(@capacity) { [] }
    @size = 0
    # 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for bucket in buckets
      for pair in bucket
        put(pair.key, pair.val)
      end
    end
  end

  ### 해시 테이블 출력 ###
  def print
    for bucket in @buckets
      res = []
      for pair in bucket
        res << "#{pair.key} -> #{pair.val}"
      end
      pp res
    end
  end
end
코드 시각화
연결 리스트가 매우 길어지면 \(O(n)\)의 조회 효율은 나빠진다. 이때 연결 리스트를 ‘AVL 트리’나 ‘레드-블랙 트리’로 바꾸면 조회의 시간 복잡도를 \(O(\log n)\)으로 개선할 수 있다.
6.2.2 개방 주소법
개방 주소법(open addressing)은 추가 자료 구조를 도입하지 않고 ‘여러 차례 탐사’하여 해시 충돌을 처리한다. 대표적인 탐사 방식에는 선형 탐사, 이차 탐사, 다중 해싱 등이 있다.
선형 탐사를 예로 개방 주소법 해시 테이블의 작동 원리를 알아보자.
1. 선형 탐사
선형 탐사는 고정 간격의 선형 탐색으로 탐사하며, 일반 해시 테이블과 연산 방식이 다르다.
- 원소 삽입: 해시 함수로 버킷 인덱스를 구한다. 이미 원소가 있으면 충돌 위치부터 뒤로 일정한 간격(보통 \(1\))으로 순회하여 빈 버킷을 찾고 원소를 넣는다.
- 원소 탐색: 해시 충돌이 있으면 같은 간격으로 뒤를 순회하다가 해당 원소를 찾으면
value를 반환한다. 빈 버킷을 만나면 목표 원소가 없다는 뜻이므로None을 반환한다.
아래 그림(6-6)은 개방 주소법(선형 탐사) 해시 테이블의 키-값 쌍 분포를 보여 준다. 이 해시 함수에서는 마지막 두 자리가 같은 key가 모두 같은 버킷에 매핑된다. 선형 탐사를 통해 이들은 해당 버킷과 그 뒤의 버킷에 차례로 저장된다.
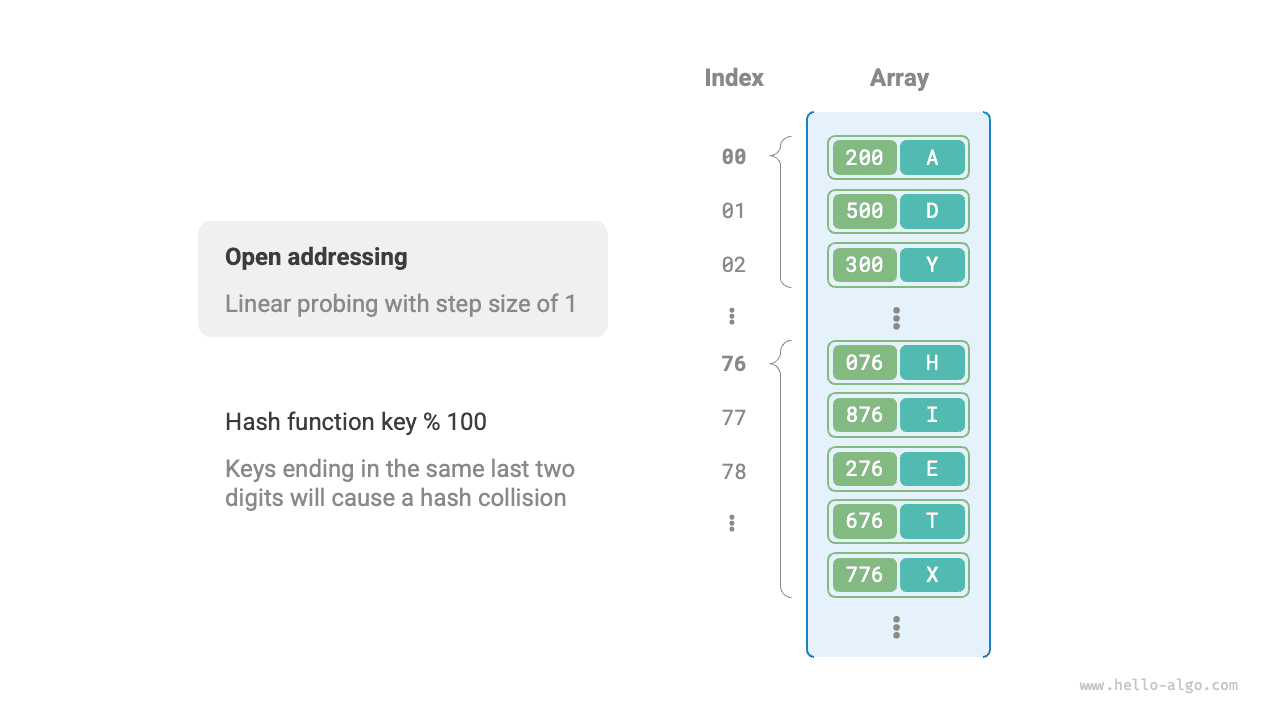
그림 6-6 개방 주소법(선형 탐사) 해시 테이블의 키-값 쌍 분포
하지만 선형 탐사에서는 ‘군집 현상’이 쉽게 발생한다. 배열에서 연속으로 채워진 구간이 길수록 그 구간에서 충돌할 가능성도 커진다. 그 결과 군집이 더욱 커지는 악순환이 생기고, 결국 삽입, 삭제, 탐색, 갱신의 효율이 낮아진다.
개방 주소법 해시 테이블에서는 원소를 곧바로 삭제하면 안 된다는 점에 주의하자. 삭제하면 배열에 빈 버킷 None이 생긴다. 조회 중 선형 탐사가 이 버킷에 도달하면 바로 반환하므로 그 뒤의 원소에 접근할 수 없게 된다. 아래 그림(6-7)과 같이 프로그램이 그 원소들을 존재하지 않는다고 잘못 판단할 수 있다.
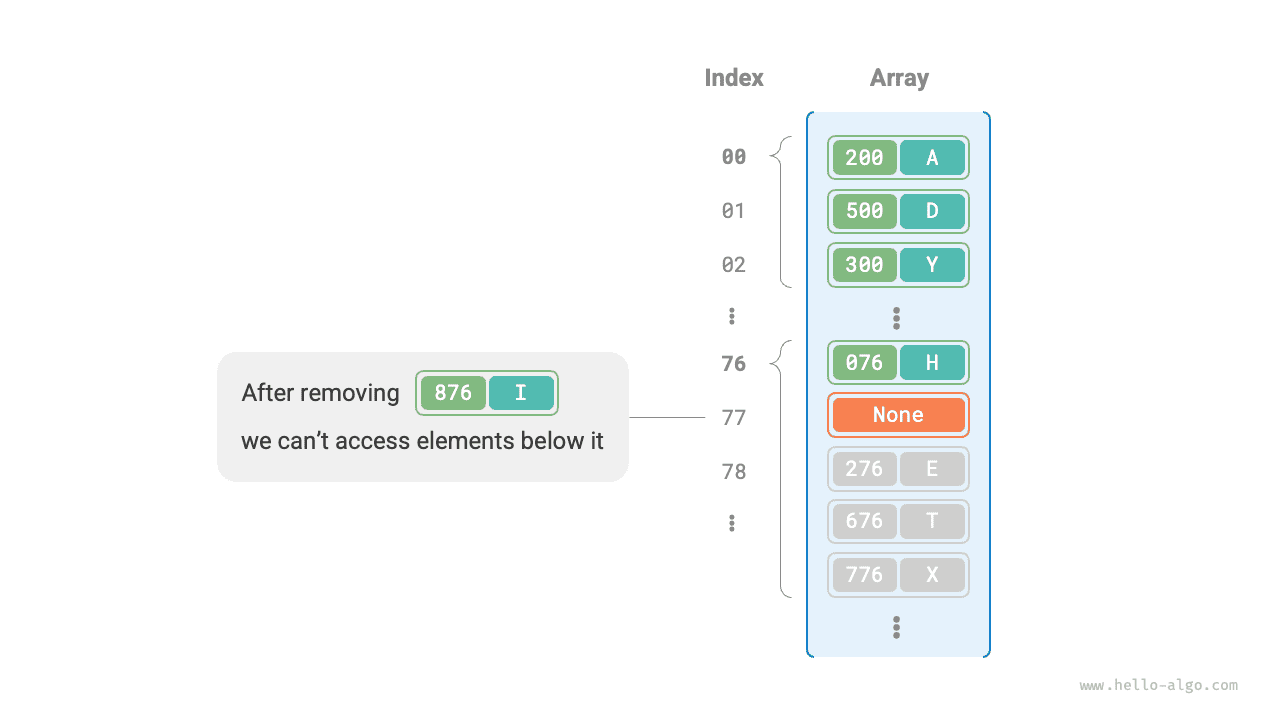
그림 6-7 개방 주소법에서 원소 삭제로 발생하는 조회 문제
이 문제는 지연 삭제(lazy deletion)로 해결할 수 있다. 원소를 해시 테이블에서 곧바로 제거하지 않고 상수 TOMBSTONE으로 해당 버킷을 표시한다. None과 TOMBSTONE은 모두 빈 버킷을 나타내며 새 키-값 쌍을 넣을 수 있다. 하지만 TOMBSTONE을 만나면 그 뒤에도 키-값 쌍이 있을 수 있으므로 탐사를 계속해야 한다.
그러나 지연 삭제는 해시 테이블의 성능 저하를 가속할 수 있다. 삭제할 때마다 삭제 표시가 생기므로 TOMBSTONE이 늘어날수록 탐색 시간도 길어진다. 목표 원소를 찾기 위해 여러 TOMBSTONE을 건너뛰어야 할 수 있기 때문이다.
이를 위해 선형 탐사 중 처음 만난 TOMBSTONE의 인덱스를 기록하고, 찾은 목표 원소와 그 TOMBSTONE의 위치를 교환하는 방법을 생각할 수 있다. 조회하거나 추가할 때마다 원소가 이상적인 위치(탐사 시작점)에 더 가까운 버킷으로 옮겨지므로 조회 효율이 좋아진다.
다음 코드는 지연 삭제를 포함한 개방 주소법(선형 탐사) 해시 테이블을 구현한다. 공간을 더 충분히 활용하기 위해 해시 테이블을 ‘원형 배열’로 보고, 끝을 넘으면 처음으로 돌아와 순회를 계속한다.
class HashMapOpenAddressing:
    """개방 주소법 해시 테이블"""

    def __init__(self):
        """생성자"""
        self.size = 0  # 키-값 쌍 개수
        self.capacity = 4  # 해시 테이블 용량
        self.load_thres = 2.0 / 3.0  # 용량 확장을 수행하는 적재율 임계값
        self.extend_ratio = 2  # 용량 확장 배수
        self.buckets: list[Pair | None] = [None] * self.capacity  # 버킷 배열
        self.TOMBSTONE = Pair(-1, "-1")  # 삭제 표시

    def hash_func(self, key: int) -> int:
        """해시 함수"""
        return key % self.capacity

    def load_factor(self) -> float:
        """적재율"""
        return self.size / self.capacity

    def find_bucket(self, key: int) -> int:
        """key에 해당하는 버킷 인덱스 탐색"""
        index = self.hash_func(key)
        first_tombstone = -1
        # 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while self.buckets[index] is not None:
            # key를 만나면 해당 버킷 인덱스를 반환한다
            if self.buckets[index].key == key:
                # 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if first_tombstone != -1:
                    self.buckets[first_tombstone] = self.buckets[index]
                    self.buckets[index] = self.TOMBSTONE
                    return first_tombstone  # 옮긴 후의 버킷 인덱스를 반환한다
                return index  # 버킷 인덱스를 반환한다
            # 처음 만난 삭제 표시를 기록한다
            if first_tombstone == -1 and self.buckets[index] is self.TOMBSTONE:
                first_tombstone = index
            # 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % self.capacity
        # key가 없으면 추가할 위치의 인덱스를 반환한다
        return index if first_tombstone == -1 else first_tombstone

    def get(self, key: int) -> str:
        """조회 연산"""
        # key에 해당하는 버킷 인덱스 탐색
        index = self.find_bucket(key)
        # 키-값 쌍을 찾으면 해당 val을 반환한다
        if self.buckets[index] not in [None, self.TOMBSTONE]:
            return self.buckets[index].val
        # 키-값 쌍이 없으면 None을 반환한다
        return None

    def put(self, key: int, val: str):
        """추가 연산"""
        # 적재율이 임계값을 초과하면 용량을 확장한다
        if self.load_factor() > self.load_thres:
            self.extend()
        # key에 해당하는 버킷 인덱스 탐색
        index = self.find_bucket(key)
        # 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if self.buckets[index] not in [None, self.TOMBSTONE]:
            self.buckets[index].val = val
            return
        # 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        self.buckets[index] = Pair(key, val)
        self.size += 1

    def remove(self, key: int):
        """삭제 연산"""
        # key에 해당하는 버킷 인덱스 탐색
        index = self.find_bucket(key)
        # 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if self.buckets[index] not in [None, self.TOMBSTONE]:
            self.buckets[index] = self.TOMBSTONE
            self.size -= 1

    def extend(self):
        """해시 테이블 용량 확장"""
        # 원래 해시 테이블을 임시로 저장한다
        buckets_tmp = self.buckets
        # 용량을 확장한 새 해시 테이블을 초기화한다
        self.capacity *= self.extend_ratio
        self.buckets = [None] * self.capacity
        self.size = 0
        # 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for pair in buckets_tmp:
            if pair not in [None, self.TOMBSTONE]:
                self.put(pair.key, pair.val)

    def print(self):
        """해시 테이블 출력"""
        for pair in self.buckets:
            if pair is None:
                print("None")
            elif pair is self.TOMBSTONE:
                print("TOMBSTONE")
            else:
                print(pair.key, "->", pair.val)
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
  private:
    int size;                             // 키-값 쌍 개수
    int capacity = 4;                     // 해시 테이블 용량
    const double loadThres = 2.0 / 3.0;     // 용량 확장을 수행하는 적재율 임계값
    const int extendRatio = 2;            // 용량 확장 배수
    vector<Pair *> buckets;               // 버킷 배열
    Pair *TOMBSTONE = new Pair(-1, "-1"); // 삭제 표시

  public:
    /* 생성자 */
    HashMapOpenAddressing() : size(0), buckets(capacity, nullptr) {
    }

    /* 소멸자 */
    ~HashMapOpenAddressing() {
        for (Pair *pair : buckets) {
            if (pair != nullptr && pair != TOMBSTONE) {
                delete pair;
            }
        }
        delete TOMBSTONE;
    }

    /* 해시 함수 */
    int hashFunc(int key) {
        return key % capacity;
    }

    /* 적재율 */
    double loadFactor() {
        return (double)size / capacity;
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    int findBucket(int key) {
        int index = hashFunc(key);
        int firstTombstone = -1;
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while (buckets[index] != nullptr) {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if (buckets[index]->key == key) {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if (firstTombstone != -1) {
                    buckets[firstTombstone] = buckets[index];
                    buckets[index] = TOMBSTONE;
                    return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index; // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if (firstTombstone == -1 && buckets[index] == TOMBSTONE) {
                firstTombstone = index;
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % capacity;
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return firstTombstone == -1 ? index : firstTombstone;
    }

    /* 조회 연산 */
    string get(int key) {
        // key에 해당하는 버킷 인덱스 탐색
        int index = findBucket(key);
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {
            return buckets[index]->val;
        }
        // 키-값 쌍이 없으면 빈 문자열을 반환한다
        return "";
    }

    /* 추가 연산 */
    void put(int key, string val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (loadFactor() > loadThres) {
            extend();
        }
        // key에 해당하는 버킷 인덱스 탐색
        int index = findBucket(key);
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {
            buckets[index]->val = val;
            return;
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        buckets[index] = new Pair(key, val);
        size++;
    }

    /* 삭제 연산 */
    void remove(int key) {
        // key에 해당하는 버킷 인덱스 탐색
        int index = findBucket(key);
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if (buckets[index] != nullptr && buckets[index] != TOMBSTONE) {
            delete buckets[index];
            buckets[index] = TOMBSTONE;
            size--;
        }
    }

    /* 해시 테이블 용량 확장 */
    void extend() {
        // 원래 해시 테이블을 임시로 저장한다
        vector<Pair *> bucketsTmp = buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio;
        buckets = vector<Pair *>(capacity, nullptr);
        size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (Pair *pair : bucketsTmp) {
            if (pair != nullptr && pair != TOMBSTONE) {
                put(pair->key, pair->val);
                delete pair;
            }
        }
    }

    /* 해시 테이블 출력 */
    void print() {
        for (Pair *pair : buckets) {
            if (pair == nullptr) {
                cout << "nullptr" << endl;
            } else if (pair == TOMBSTONE) {
                cout << "TOMBSTONE" << endl;
            } else {
                cout << pair->key << " -> " << pair->val << endl;
            }
        }
    }
};
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
    private int size; // 키-값 쌍 개수
    private int capacity = 4; // 해시 테이블 용량
    private final double loadThres = 2.0 / 3.0; // 용량 확장을 수행하는 적재율 임계값
    private final int extendRatio = 2; // 용량 확장 배수
    private Pair[] buckets; // 버킷 배열
    private final Pair TOMBSTONE = new Pair(-1, "-1"); // 삭제 표시

    /* 생성자 */
    public HashMapOpenAddressing() {
        size = 0;
        buckets = new Pair[capacity];
    }

    /* 해시 함수 */
    private int hashFunc(int key) {
        return key % capacity;
    }

    /* 적재율 */
    private double loadFactor() {
        return (double) size / capacity;
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    private int findBucket(int key) {
        int index = hashFunc(key);
        int firstTombstone = -1;
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while (buckets[index] != null) {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if (buckets[index].key == key) {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if (firstTombstone != -1) {
                    buckets[firstTombstone] = buckets[index];
                    buckets[index] = TOMBSTONE;
                    return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index; // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if (firstTombstone == -1 && buckets[index] == TOMBSTONE) {
                firstTombstone = index;
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % capacity;
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return firstTombstone == -1 ? index : firstTombstone;
    }

    /* 조회 연산 */
    public String get(int key) {
        // key에 해당하는 버킷 인덱스 탐색
        int index = findBucket(key);
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            return buckets[index].val;
        }
        // 키-값 쌍이 없으면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    public void put(int key, String val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (loadFactor() > loadThres) {
            extend();
        }
        // key에 해당하는 버킷 인덱스 탐색
        int index = findBucket(key);
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            buckets[index].val = val;
            return;
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        buckets[index] = new Pair(key, val);
        size++;
    }

    /* 삭제 연산 */
    public void remove(int key) {
        // key에 해당하는 버킷 인덱스 탐색
        int index = findBucket(key);
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            buckets[index] = TOMBSTONE;
            size--;
        }
    }

    /* 해시 테이블 용량 확장 */
    private void extend() {
        // 원래 해시 테이블을 임시로 저장한다
        Pair[] bucketsTmp = buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio;
        buckets = new Pair[capacity];
        size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (Pair pair : bucketsTmp) {
            if (pair != null && pair != TOMBSTONE) {
                put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    public void print() {
        for (Pair pair : buckets) {
            if (pair == null) {
                System.out.println("null");
            } else if (pair == TOMBSTONE) {
                System.out.println("TOMBSTONE");
            } else {
                System.out.println(pair.key + " -> " + pair.val);
            }
        }
    }
}
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
    int size; // 키-값 쌍 개수
    int capacity = 4; // 해시 테이블 용량
    double loadThres = 2.0 / 3.0; // 용량 확장을 수행하는 적재율 임계값
    int extendRatio = 2; // 용량 확장 배수
    Pair[] buckets; // 버킷 배열
    Pair TOMBSTONE = new(-1, "-1"); // 삭제 표시

    /* 생성자 */
    public HashMapOpenAddressing() {
        size = 0;
        buckets = new Pair[capacity];
    }

    /* 해시 함수 */
    int HashFunc(int key) {
        return key % capacity;
    }

    /* 적재율 */
    double LoadFactor() {
        return (double)size / capacity;
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    int FindBucket(int key) {
        int index = HashFunc(key);
        int firstTombstone = -1;
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while (buckets[index] != null) {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if (buckets[index].key == key) {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if (firstTombstone != -1) {
                    buckets[firstTombstone] = buckets[index];
                    buckets[index] = TOMBSTONE;
                    return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index; // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if (firstTombstone == -1 && buckets[index] == TOMBSTONE) {
                firstTombstone = index;
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % capacity;
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return firstTombstone == -1 ? index : firstTombstone;
    }

    /* 조회 연산 */
    public string? Get(int key) {
        // key에 해당하는 버킷 인덱스 탐색
        int index = FindBucket(key);
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            return buckets[index].val;
        }
        // 키-값 쌍이 없으면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    public void Put(int key, string val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (LoadFactor() > loadThres) {
            Extend();
        }
        // key에 해당하는 버킷 인덱스 탐색
        int index = FindBucket(key);
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            buckets[index].val = val;
            return;
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        buckets[index] = new Pair(key, val);
        size++;
    }

    /* 삭제 연산 */
    public void Remove(int key) {
        // key에 해당하는 버킷 인덱스 탐색
        int index = FindBucket(key);
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            buckets[index] = TOMBSTONE;
            size--;
        }
    }

    /* 해시 테이블 용량 확장 */
    void Extend() {
        // 원래 해시 테이블을 임시로 저장한다
        Pair[] bucketsTmp = buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio;
        buckets = new Pair[capacity];
        size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        foreach (Pair pair in bucketsTmp) {
            if (pair != null && pair != TOMBSTONE) {
                Put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    public void Print() {
        foreach (Pair pair in buckets) {
            if (pair == null) {
                Console.WriteLine("null");
            } else if (pair == TOMBSTONE) {
                Console.WriteLine("TOMBSTONE");
            } else {
                Console.WriteLine(pair.key + " -> " + pair.val);
            }
        }
    }
}
/* 개방 주소법 해시 테이블 */
type hashMapOpenAddressing struct {
    size        int     // 키-값 쌍 개수
    capacity    int     // 해시 테이블 용량
    loadThres   float64 // 용량 확장을 수행하는 적재율 임계값
    extendRatio int     // 용량 확장 배수
    buckets     []*pair // 버킷 배열
    TOMBSTONE   *pair   // 삭제 표시
}

/* 생성자 */
func newHashMapOpenAddressing() *hashMapOpenAddressing {
    return &hashMapOpenAddressing{
        size:        0,
        capacity:    4,
        loadThres:   2.0 / 3.0,
        extendRatio: 2,
        buckets:     make([]*pair, 4),
        TOMBSTONE:   &pair{-1, "-1"},
    }
}

/* 해시 함수 */
func (h *hashMapOpenAddressing) hashFunc(key int) int {
    return key % h.capacity // 키를 바탕으로 해시값을 계산한다
}

/* 적재율 */
func (h *hashMapOpenAddressing) loadFactor() float64 {
    return float64(h.size) / float64(h.capacity) // 현재 적재율을 계산한다
}

/* key에 해당하는 버킷 인덱스 탐색 */
func (h *hashMapOpenAddressing) findBucket(key int) int {
    index := h.hashFunc(key) // 초기 인덱스를 구한다
    firstTombstone := -1     // 처음 만난 TOMBSTONE의 위치를 기록한다
    for h.buckets[index] != nil {
        if h.buckets[index].key == key {
            if firstTombstone != -1 {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                h.buckets[firstTombstone] = h.buckets[index]
                h.buckets[index] = h.TOMBSTONE
                return firstTombstone // 옮긴 후의 버킷 인덱스를 반환한다
            }
            return index // 찾은 인덱스를 반환한다
        }
        if firstTombstone == -1 && h.buckets[index] == h.TOMBSTONE {
            firstTombstone = index // 처음 만난 삭제 표시의 위치를 기록한다
        }
        index = (index + 1) % h.capacity // 선형 탐사를 수행하며, 끝을 넘어가면 처음으로 돌아온다
    }
    // key가 없으면 추가할 위치의 인덱스를 반환한다
    if firstTombstone != -1 {
        return firstTombstone
    }
    return index
}

/* 조회 연산 */
func (h *hashMapOpenAddressing) get(key int) string {
    index := h.findBucket(key) // key에 해당하는 버킷 인덱스 탐색
    if h.buckets[index] != nil && h.buckets[index] != h.TOMBSTONE {
        return h.buckets[index].val // 키-값 쌍을 찾으면 해당 val을 반환한다
    }
    return "" // 키-값 쌍이 없으면 ""를 반환한다
}

/* 추가 연산 */
func (h *hashMapOpenAddressing) put(key int, val string) {
    if h.loadFactor() > h.loadThres {
        h.extend() // 적재율이 임계값을 초과하면 용량을 확장한다
    }
    index := h.findBucket(key) // key에 해당하는 버킷 인덱스 탐색
    if h.buckets[index] == nil || h.buckets[index] == h.TOMBSTONE {
        h.buckets[index] = &pair{key, val} // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        h.size++
    } else {
        h.buckets[index].val = val // 키-값 쌍을 찾으면 val을 덮어쓴다
    }
}

/* 삭제 연산 */
func (h *hashMapOpenAddressing) remove(key int) {
    index := h.findBucket(key) // key에 해당하는 버킷 인덱스 탐색
    if h.buckets[index] != nil && h.buckets[index] != h.TOMBSTONE {
        h.buckets[index] = h.TOMBSTONE // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        h.size--
    }
}

/* 해시 테이블 용량 확장 */
func (h *hashMapOpenAddressing) extend() {
    oldBuckets := h.buckets               // 원래 해시 테이블을 임시로 저장한다
    h.capacity *= h.extendRatio           // 용량을 갱신한다
    h.buckets = make([]*pair, h.capacity) // 용량을 확장한 새 해시 테이블을 초기화한다
    h.size = 0                            // 크기를 초기화한다
    // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for _, pair := range oldBuckets {
        if pair != nil && pair != h.TOMBSTONE {
            h.put(pair.key, pair.val)
        }
    }
}

/* 해시 테이블 출력 */
func (h *hashMapOpenAddressing) print() {
    for _, pair := range h.buckets {
        if pair == nil {
            fmt.Println("nil")
        } else if pair == h.TOMBSTONE {
            fmt.Println("TOMBSTONE")
        } else {
            fmt.Printf("%d -> %s\n", pair.key, pair.val)
        }
    }
}
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
    var size: Int // 키-값 쌍 개수
    var capacity: Int // 해시 테이블 용량
    var loadThres: Double // 용량 확장을 수행하는 적재율 임계값
    var extendRatio: Int // 용량 확장 배수
    var buckets: [Pair?] // 버킷 배열
    var TOMBSTONE: Pair // 삭제 표시

    /* 생성자 */
    init() {
        size = 0
        capacity = 4
        loadThres = 2.0 / 3.0
        extendRatio = 2
        buckets = Array(repeating: nil, count: capacity)
        TOMBSTONE = Pair(key: -1, val: "-1")
    }

    /* 해시 함수 */
    func hashFunc(key: Int) -> Int {
        key % capacity
    }

    /* 적재율 */
    func loadFactor() -> Double {
        Double(size) / Double(capacity)
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    func findBucket(key: Int) -> Int {
        var index = hashFunc(key: key)
        var firstTombstone = -1
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while buckets[index] != nil {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if buckets[index]!.key == key {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if firstTombstone != -1 {
                    buckets[firstTombstone] = buckets[index]
                    buckets[index] = TOMBSTONE
                    return firstTombstone // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if firstTombstone == -1 && buckets[index] == TOMBSTONE {
                firstTombstone = index
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % capacity
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return firstTombstone == -1 ? index : firstTombstone
    }

    /* 조회 연산 */
    func get(key: Int) -> String? {
        // key에 해당하는 버킷 인덱스 탐색
        let index = findBucket(key: key)
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if buckets[index] != nil, buckets[index] != TOMBSTONE {
            return buckets[index]!.val
        }
        // 키-값 쌍이 없으면 null을 반환한다
        return nil
    }

    /* 추가 연산 */
    func put(key: Int, val: String) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if loadFactor() > loadThres {
            extend()
        }
        // key에 해당하는 버킷 인덱스 탐색
        let index = findBucket(key: key)
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if buckets[index] != nil, buckets[index] != TOMBSTONE {
            buckets[index]!.val = val
            return
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        buckets[index] = Pair(key: key, val: val)
        size += 1
    }

    /* 삭제 연산 */
    func remove(key: Int) {
        // key에 해당하는 버킷 인덱스 탐색
        let index = findBucket(key: key)
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if buckets[index] != nil, buckets[index] != TOMBSTONE {
            buckets[index] = TOMBSTONE
            size -= 1
        }
    }

    /* 해시 테이블 용량 확장 */
    func extend() {
        // 원래 해시 테이블을 임시로 저장한다
        let bucketsTmp = buckets
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio
        buckets = Array(repeating: nil, count: capacity)
        size = 0
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for pair in bucketsTmp {
            if let pair, pair != TOMBSTONE {
                put(key: pair.key, val: pair.val)
            }
        }
    }

    /* 해시 테이블 출력 */
    func print() {
        for pair in buckets {
            if pair == nil {
                Swift.print("null")
            } else if pair == TOMBSTONE {
                Swift.print("TOMBSTONE")
            } else {
                Swift.print("\(pair!.key) -> \(pair!.val)")
            }
        }
    }
}
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
    #size; // 키-값 쌍 개수
    #capacity; // 해시 테이블 용량
    #loadThres; // 용량 확장을 수행하는 적재율 임계값
    #extendRatio; // 용량 확장 배수
    #buckets; // 버킷 배열
    #TOMBSTONE; // 삭제 표시

    /* 생성자 */
    constructor() {
        this.#size = 0; // 키-값 쌍 개수
        this.#capacity = 4; // 해시 테이블 용량
        this.#loadThres = 2.0 / 3.0; // 용량 확장을 수행하는 적재율 임계값
        this.#extendRatio = 2; // 용량 확장 배수
        this.#buckets = Array(this.#capacity).fill(null); // 버킷 배열
        this.#TOMBSTONE = new Pair(-1, '-1'); // 삭제 표시
    }

    /* 해시 함수 */
    #hashFunc(key) {
        return key % this.#capacity;
    }

    /* 적재율 */
    #loadFactor() {
        return this.#size / this.#capacity;
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    #findBucket(key) {
        let index = this.#hashFunc(key);
        let firstTombstone = -1;
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while (this.#buckets[index] !== null) {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if (this.#buckets[index].key === key) {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if (firstTombstone !== -1) {
                    this.#buckets[firstTombstone] = this.#buckets[index];
                    this.#buckets[index] = this.#TOMBSTONE;
                    return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index; // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if (
                firstTombstone === -1 &&
                this.#buckets[index] === this.#TOMBSTONE
            ) {
                firstTombstone = index;
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % this.#capacity;
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return firstTombstone === -1 ? index : firstTombstone;
    }

    /* 조회 연산 */
    get(key) {
        // key에 해당하는 버킷 인덱스 탐색
        const index = this.#findBucket(key);
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if (
            this.#buckets[index] !== null &&
            this.#buckets[index] !== this.#TOMBSTONE
        ) {
            return this.#buckets[index].val;
        }
        // 키-값 쌍이 없으면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    put(key, val) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (this.#loadFactor() > this.#loadThres) {
            this.#extend();
        }
        // key에 해당하는 버킷 인덱스 탐색
        const index = this.#findBucket(key);
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if (
            this.#buckets[index] !== null &&
            this.#buckets[index] !== this.#TOMBSTONE
        ) {
            this.#buckets[index].val = val;
            return;
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        this.#buckets[index] = new Pair(key, val);
        this.#size++;
    }

    /* 삭제 연산 */
    remove(key) {
        // key에 해당하는 버킷 인덱스 탐색
        const index = this.#findBucket(key);
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if (
            this.#buckets[index] !== null &&
            this.#buckets[index] !== this.#TOMBSTONE
        ) {
            this.#buckets[index] = this.#TOMBSTONE;
            this.#size--;
        }
    }

    /* 해시 테이블 용량 확장 */
    #extend() {
        // 원래 해시 테이블을 임시로 저장한다
        const bucketsTmp = this.#buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        this.#capacity *= this.#extendRatio;
        this.#buckets = Array(this.#capacity).fill(null);
        this.#size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (const pair of bucketsTmp) {
            if (pair !== null && pair !== this.#TOMBSTONE) {
                this.put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    print() {
        for (const pair of this.#buckets) {
            if (pair === null) {
                console.log('null');
            } else if (pair === this.#TOMBSTONE) {
                console.log('TOMBSTONE');
            } else {
                console.log(pair.key + ' -> ' + pair.val);
            }
        }
    }
}
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
    private size: number; // 키-값 쌍 개수
    private capacity: number; // 해시 테이블 용량
    private loadThres: number; // 용량 확장을 수행하는 적재율 임계값
    private extendRatio: number; // 용량 확장 배수
    private buckets: Array<Pair | null>; // 버킷 배열
    private TOMBSTONE: Pair; // 삭제 표시

    /* 생성자 */
    constructor() {
        this.size = 0; // 키-값 쌍 개수
        this.capacity = 4; // 해시 테이블 용량
        this.loadThres = 2.0 / 3.0; // 용량 확장을 수행하는 적재율 임계값
        this.extendRatio = 2; // 용량 확장 배수
        this.buckets = Array(this.capacity).fill(null); // 버킷 배열
        this.TOMBSTONE = new Pair(-1, '-1'); // 삭제 표시
    }

    /* 해시 함수 */
    private hashFunc(key: number): number {
        return key % this.capacity;
    }

    /* 적재율 */
    private loadFactor(): number {
        return this.size / this.capacity;
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    private findBucket(key: number): number {
        let index = this.hashFunc(key);
        let firstTombstone = -1;
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while (this.buckets[index] !== null) {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if (this.buckets[index]!.key === key) {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if (firstTombstone !== -1) {
                    this.buckets[firstTombstone] = this.buckets[index];
                    this.buckets[index] = this.TOMBSTONE;
                    return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index; // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if (
                firstTombstone === -1 &&
                this.buckets[index] === this.TOMBSTONE
            ) {
                firstTombstone = index;
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % this.capacity;
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return firstTombstone === -1 ? index : firstTombstone;
    }

    /* 조회 연산 */
    get(key: number): string | null {
        // key에 해당하는 버킷 인덱스 탐색
        const index = this.findBucket(key);
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if (
            this.buckets[index] !== null &&
            this.buckets[index] !== this.TOMBSTONE
        ) {
            return this.buckets[index]!.val;
        }
        // 키-값 쌍이 없으면 null을 반환한다
        return null;
    }

    /* 추가 연산 */
    put(key: number, val: string): void {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (this.loadFactor() > this.loadThres) {
            this.extend();
        }
        // key에 해당하는 버킷 인덱스 탐색
        const index = this.findBucket(key);
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if (
            this.buckets[index] !== null &&
            this.buckets[index] !== this.TOMBSTONE
        ) {
            this.buckets[index]!.val = val;
            return;
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        this.buckets[index] = new Pair(key, val);
        this.size++;
    }

    /* 삭제 연산 */
    remove(key: number): void {
        // key에 해당하는 버킷 인덱스 탐색
        const index = this.findBucket(key);
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if (
            this.buckets[index] !== null &&
            this.buckets[index] !== this.TOMBSTONE
        ) {
            this.buckets[index] = this.TOMBSTONE;
            this.size--;
        }
    }

    /* 해시 테이블 용량 확장 */
    private extend(): void {
        // 원래 해시 테이블을 임시로 저장한다
        const bucketsTmp = this.buckets;
        // 용량을 확장한 새 해시 테이블을 초기화한다
        this.capacity *= this.extendRatio;
        this.buckets = Array(this.capacity).fill(null);
        this.size = 0;
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (const pair of bucketsTmp) {
            if (pair !== null && pair !== this.TOMBSTONE) {
                this.put(pair.key, pair.val);
            }
        }
    }

    /* 해시 테이블 출력 */
    print(): void {
        for (const pair of this.buckets) {
            if (pair === null) {
                console.log('null');
            } else if (pair === this.TOMBSTONE) {
                console.log('TOMBSTONE');
            } else {
                console.log(pair.key + ' -> ' + pair.val);
            }
        }
    }
}
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
  late int _size; // 키-값 쌍 개수
  int _capacity = 4; // 해시 테이블 용량
  double _loadThres = 2.0 / 3.0; // 용량 확장을 수행하는 적재율 임계값
  int _extendRatio = 2; // 용량 확장 배수
  late List<Pair?> _buckets; // 버킷 배열
  Pair _TOMBSTONE = Pair(-1, "-1"); // 삭제 표시

  /* 생성자 */
  HashMapOpenAddressing() {
    _size = 0;
    _buckets = List.generate(_capacity, (index) => null);
  }

  /* 해시 함수 */
  int hashFunc(int key) {
    return key % _capacity;
  }

  /* 적재율 */
  double loadFactor() {
    return _size / _capacity;
  }

  /* key에 해당하는 버킷 인덱스 탐색 */
  int findBucket(int key) {
    int index = hashFunc(key);
    int firstTombstone = -1;
    // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
    while (_buckets[index] != null) {
      // key를 만나면 해당 버킷 인덱스를 반환한다
      if (_buckets[index]!.key == key) {
        // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
        if (firstTombstone != -1) {
          _buckets[firstTombstone] = _buckets[index];
          _buckets[index] = _TOMBSTONE;
          return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
        }
        return index; // 버킷 인덱스를 반환한다
      }
      // 처음 만난 삭제 표시를 기록한다
      if (firstTombstone == -1 && _buckets[index] == _TOMBSTONE) {
        firstTombstone = index;
      }
      // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
      index = (index + 1) % _capacity;
    }
    // key가 없으면 추가할 위치의 인덱스를 반환한다
    return firstTombstone == -1 ? index : firstTombstone;
  }

  /* 조회 연산 */
  String? get(int key) {
    // key에 해당하는 버킷 인덱스 탐색
    int index = findBucket(key);
    // 키-값 쌍을 찾으면 해당 val을 반환한다
    if (_buckets[index] != null && _buckets[index] != _TOMBSTONE) {
      return _buckets[index]!.val;
    }
    // 키-값 쌍이 없으면 null을 반환한다
    return null;
  }

  /* 추가 연산 */
  void put(int key, String val) {
    // 적재율이 임계값을 초과하면 용량을 확장한다
    if (loadFactor() > _loadThres) {
      extend();
    }
    // key에 해당하는 버킷 인덱스 탐색
    int index = findBucket(key);
    // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
    if (_buckets[index] != null && _buckets[index] != _TOMBSTONE) {
      _buckets[index]!.val = val;
      return;
    }
    // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
    _buckets[index] = new Pair(key, val);
    _size++;
  }

  /* 삭제 연산 */
  void remove(int key) {
    // key에 해당하는 버킷 인덱스 탐색
    int index = findBucket(key);
    // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
    if (_buckets[index] != null && _buckets[index] != _TOMBSTONE) {
      _buckets[index] = _TOMBSTONE;
      _size--;
    }
  }

  /* 해시 테이블 용량 확장 */
  void extend() {
    // 원래 해시 테이블을 임시로 저장한다
    List<Pair?> bucketsTmp = _buckets;
    // 용량을 확장한 새 해시 테이블을 초기화한다
    _capacity *= _extendRatio;
    _buckets = List.generate(_capacity, (index) => null);
    _size = 0;
    // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for (Pair? pair in bucketsTmp) {
      if (pair != null && pair != _TOMBSTONE) {
        put(pair.key, pair.val);
      }
    }
  }

  /* 해시 테이블 출력 */
  void printHashMap() {
    for (Pair? pair in _buckets) {
      if (pair == null) {
        print("null");
      } else if (pair == _TOMBSTONE) {
        print("TOMBSTONE");
      } else {
        print("${pair.key} -> ${pair.val}");
      }
    }
  }
}
/* 개방 주소법 해시 테이블 */
struct HashMapOpenAddressing {
    size: usize,                // 키-값 쌍 개수
    capacity: usize,            // 해시 테이블 용량
    load_thres: f64,            // 용량 확장을 수행하는 적재율 임계값
    extend_ratio: usize,        // 용량 확장 배수
    buckets: Vec<Option<Pair>>, // 버킷 배열
    TOMBSTONE: Option<Pair>,    // 삭제 표시
}

impl HashMapOpenAddressing {
    /* 생성자 */
    fn new() -> Self {
        Self {
            size: 0,
            capacity: 4,
            load_thres: 2.0 / 3.0,
            extend_ratio: 2,
            buckets: vec![None; 4],
            TOMBSTONE: Some(Pair {
                key: -1,
                val: "-1".to_string(),
            }),
        }
    }

    /* 해시 함수 */
    fn hash_func(&self, key: i32) -> usize {
        (key % self.capacity as i32) as usize
    }

    /* 적재율 */
    fn load_factor(&self) -> f64 {
        self.size as f64 / self.capacity as f64
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    fn find_bucket(&mut self, key: i32) -> usize {
        let mut index = self.hash_func(key);
        let mut first_tombstone = -1;
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while self.buckets[index].is_some() {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if self.buckets[index].as_ref().unwrap().key == key {
                // 앞서 삭제 표시를 만났다면 키-값 쌍을 해당 인덱스로 옮긴다
                if first_tombstone != -1 {
                    self.buckets[first_tombstone as usize] = self.buckets[index].take();
                    self.buckets[index] = self.TOMBSTONE.clone();
                    return first_tombstone as usize; // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index; // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if first_tombstone == -1 && self.buckets[index] == self.TOMBSTONE {
                first_tombstone = index as i32;
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % self.capacity;
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        if first_tombstone == -1 {
            index
        } else {
            first_tombstone as usize
        }
    }

    /* 조회 연산 */
    fn get(&mut self, key: i32) -> Option<&str> {
        // key에 해당하는 버킷 인덱스 탐색
        let index = self.find_bucket(key);
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if self.buckets[index].is_some() && self.buckets[index] != self.TOMBSTONE {
            return self.buckets[index].as_ref().map(|pair| &pair.val as &str);
        }
        // 키-값 쌍이 없으면 null을 반환한다
        None
    }

    /* 추가 연산 */
    fn put(&mut self, key: i32, val: String) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if self.load_factor() > self.load_thres {
            self.extend();
        }
        // key에 해당하는 버킷 인덱스 탐색
        let index = self.find_bucket(key);
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if self.buckets[index].is_some() && self.buckets[index] != self.TOMBSTONE {
            self.buckets[index].as_mut().unwrap().val = val;
            return;
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        self.buckets[index] = Some(Pair { key, val });
        self.size += 1;
    }

    /* 삭제 연산 */
    fn remove(&mut self, key: i32) {
        // key에 해당하는 버킷 인덱스 탐색
        let index = self.find_bucket(key);
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if self.buckets[index].is_some() && self.buckets[index] != self.TOMBSTONE {
            self.buckets[index] = self.TOMBSTONE.clone();
            self.size -= 1;
        }
    }

    /* 해시 테이블 용량 확장 */
    fn extend(&mut self) {
        // 원래 해시 테이블을 임시로 저장한다
        let buckets_tmp = self.buckets.clone();
        // 용량을 확장한 새 해시 테이블을 초기화한다
        self.capacity *= self.extend_ratio;
        self.buckets = vec![None; self.capacity];
        self.size = 0;

        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for pair in buckets_tmp {
            if pair.is_none() || pair == self.TOMBSTONE {
                continue;
            }
            let pair = pair.unwrap();

            self.put(pair.key, pair.val);
        }
    }
    /* 해시 테이블 출력 */
    fn print(&self) {
        for pair in &self.buckets {
            if pair.is_none() {
                println!("null");
            } else if pair == &self.TOMBSTONE {
                println!("TOMBSTONE");
            } else {
                let pair = pair.as_ref().unwrap();
                println!("{} -> {}", pair.key, pair.val);
            }
        }
    }
}
/* 개방 주소법 해시 테이블 */
typedef struct {
    int size;         // 키-값 쌍 개수
    int capacity;     // 해시 테이블 용량
    double loadThres; // 용량 확장을 수행하는 적재율 임계값
    int extendRatio;  // 용량 확장 배수
    Pair **buckets;   // 버킷 배열
    Pair *TOMBSTONE;  // 삭제 표시
} HashMapOpenAddressing;

/* 생성자 */
HashMapOpenAddressing *newHashMapOpenAddressing() {
    HashMapOpenAddressing *hashMap = (HashMapOpenAddressing *)malloc(sizeof(HashMapOpenAddressing));
    hashMap->size = 0;
    hashMap->capacity = 4;
    hashMap->loadThres = 2.0 / 3.0;
    hashMap->extendRatio = 2;
    hashMap->buckets = (Pair **)calloc(hashMap->capacity, sizeof(Pair *));
    hashMap->TOMBSTONE = (Pair *)malloc(sizeof(Pair));
    hashMap->TOMBSTONE->key = -1;
    hashMap->TOMBSTONE->val = "-1";

    return hashMap;
}

/* 소멸자 */
void delHashMapOpenAddressing(HashMapOpenAddressing *hashMap) {
    for (int i = 0; i < hashMap->capacity; i++) {
        Pair *pair = hashMap->buckets[i];
        if (pair != NULL && pair != hashMap->TOMBSTONE) {
            free(pair->val);
            free(pair);
        }
    }
    free(hashMap->buckets);
    free(hashMap->TOMBSTONE);
    free(hashMap);
}

/* 해시 함수 */
int hashFunc(HashMapOpenAddressing *hashMap, int key) {
    return key % hashMap->capacity;
}

/* 적재율 */
double loadFactor(HashMapOpenAddressing *hashMap) {
    return (double)hashMap->size / (double)hashMap->capacity;
}

/* key에 해당하는 버킷 인덱스 탐색 */
int findBucket(HashMapOpenAddressing *hashMap, int key) {
    int index = hashFunc(hashMap, key);
    int firstTombstone = -1;
    // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
    while (hashMap->buckets[index] != NULL) {
        // key를 만나면 해당 버킷 인덱스를 반환한다
        if (hashMap->buckets[index]->key == key) {
            // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
            if (firstTombstone != -1) {
                hashMap->buckets[firstTombstone] = hashMap->buckets[index];
                hashMap->buckets[index] = hashMap->TOMBSTONE;
                return firstTombstone; // 옮긴 후의 버킷 인덱스를 반환한다
            }
            return index; // 버킷 인덱스를 반환한다
        }
        // 처음 만난 삭제 표시를 기록한다
        if (firstTombstone == -1 && hashMap->buckets[index] == hashMap->TOMBSTONE) {
            firstTombstone = index;
        }
        // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
        index = (index + 1) % hashMap->capacity;
    }
    // key가 없으면 추가할 위치의 인덱스를 반환한다
    return firstTombstone == -1 ? index : firstTombstone;
}

/* 조회 연산 */
char *get(HashMapOpenAddressing *hashMap, int key) {
    // key에 해당하는 버킷 인덱스 탐색
    int index = findBucket(hashMap, key);
    // 키-값 쌍을 찾으면 해당 val을 반환한다
    if (hashMap->buckets[index] != NULL && hashMap->buckets[index] != hashMap->TOMBSTONE) {
        return hashMap->buckets[index]->val;
    }
    // 키-값 쌍이 없으면 빈 문자열을 반환한다
    return "";
}

/* 추가 연산 */
void put(HashMapOpenAddressing *hashMap, int key, char *val) {
    // 적재율이 임계값을 초과하면 용량을 확장한다
    if (loadFactor(hashMap) > hashMap->loadThres) {
        extend(hashMap);
    }
    // key에 해당하는 버킷 인덱스 탐색
    int index = findBucket(hashMap, key);
    // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
    if (hashMap->buckets[index] != NULL && hashMap->buckets[index] != hashMap->TOMBSTONE) {
        free(hashMap->buckets[index]->val);
        hashMap->buckets[index]->val = (char *)malloc(sizeof(strlen(val) + 1));
        strcpy(hashMap->buckets[index]->val, val);
        hashMap->buckets[index]->val[strlen(val)] = '\0';
        return;
    }
    // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
    Pair *pair = (Pair *)malloc(sizeof(Pair));
    pair->key = key;
    pair->val = (char *)malloc(sizeof(strlen(val) + 1));
    strcpy(pair->val, val);
    pair->val[strlen(val)] = '\0';

    hashMap->buckets[index] = pair;
    hashMap->size++;
}

/* 삭제 연산 */
void removeItem(HashMapOpenAddressing *hashMap, int key) {
    // key에 해당하는 버킷 인덱스 탐색
    int index = findBucket(hashMap, key);
    // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
    if (hashMap->buckets[index] != NULL && hashMap->buckets[index] != hashMap->TOMBSTONE) {
        Pair *pair = hashMap->buckets[index];
        free(pair->val);
        free(pair);
        hashMap->buckets[index] = hashMap->TOMBSTONE;
        hashMap->size--;
    }
}

/* 해시 테이블 용량 확장 */
void extend(HashMapOpenAddressing *hashMap) {
    // 원래 해시 테이블을 임시로 저장한다
    Pair **bucketsTmp = hashMap->buckets;
    int oldCapacity = hashMap->capacity;
    // 용량을 확장한 새 해시 테이블을 초기화한다
    hashMap->capacity *= hashMap->extendRatio;
    hashMap->buckets = (Pair **)calloc(hashMap->capacity, sizeof(Pair *));
    hashMap->size = 0;
    // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for (int i = 0; i < oldCapacity; i++) {
        Pair *pair = bucketsTmp[i];
        if (pair != NULL && pair != hashMap->TOMBSTONE) {
            put(hashMap, pair->key, pair->val);
            free(pair->val);
            free(pair);
        }
    }
    free(bucketsTmp);
}

/* 해시 테이블 출력 */
void print(HashMapOpenAddressing *hashMap) {
    for (int i = 0; i < hashMap->capacity; i++) {
        Pair *pair = hashMap->buckets[i];
        if (pair == NULL) {
            printf("NULL\n");
        } else if (pair == hashMap->TOMBSTONE) {
            printf("TOMBSTONE\n");
        } else {
            printf("%d -> %s\n", pair->key, pair->val);
        }
    }
}
/* 개방 주소법 해시 테이블 */
class HashMapOpenAddressing {
    private var size: Int               // 키-값 쌍 개수
    private var capacity: Int           // 해시 테이블 용량
    private val loadThres: Double       // 용량 확장을 수행하는 적재율 임계값
    private val extendRatio: Int        // 용량 확장 배수
    private var buckets: Array<Pair?>   // 버킷 배열
    private val TOMBSTONE: Pair         // 삭제 표시

    /* 생성자 */
    init {
        size = 0
        capacity = 4
        loadThres = 2.0 / 3.0
        extendRatio = 2
        buckets = arrayOfNulls(capacity)
        TOMBSTONE = Pair(-1, "-1")
    }

    /* 해시 함수 */
    fun hashFunc(key: Int): Int {
        return key % capacity
    }

    /* 적재율 */
    fun loadFactor(): Double {
        return (size / capacity).toDouble()
    }

    /* key에 해당하는 버킷 인덱스 탐색 */
    fun findBucket(key: Int): Int {
        var index = hashFunc(key)
        var firstTombstone = -1
        // 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
        while (buckets[index] != null) {
            // key를 만나면 해당 버킷 인덱스를 반환한다
            if (buckets[index]?.key == key) {
                // 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
                if (firstTombstone != -1) {
                    buckets[firstTombstone] = buckets[index]
                    buckets[index] = TOMBSTONE
                    return firstTombstone // 옮긴 후의 버킷 인덱스를 반환한다
                }
                return index // 버킷 인덱스를 반환한다
            }
            // 처음 만난 삭제 표시를 기록한다
            if (firstTombstone == -1 && buckets[index] == TOMBSTONE) {
                firstTombstone = index
            }
            // 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
            index = (index + 1) % capacity
        }
        // key가 없으면 추가할 위치의 인덱스를 반환한다
        return if (firstTombstone == -1) index else firstTombstone
    }

    /* 조회 연산 */
    fun get(key: Int): String? {
        // key에 해당하는 버킷 인덱스 탐색
        val index = findBucket(key)
        // 키-값 쌍을 찾으면 해당 val을 반환한다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            return buckets[index]?._val
        }
        // 키-값 쌍이 없으면 null을 반환한다
        return null
    }

    /* 추가 연산 */
    fun put(key: Int, _val: String) {
        // 적재율이 임계값을 초과하면 용량을 확장한다
        if (loadFactor() > loadThres) {
            extend()
        }
        // key에 해당하는 버킷 인덱스 탐색
        val index = findBucket(key)
        // 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            buckets[index]!!._val = _val
            return
        }
        // 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
        buckets[index] = Pair(key, _val)
        size++
    }

    /* 삭제 연산 */
    fun remove(key: Int) {
        // key에 해당하는 버킷 인덱스 탐색
        val index = findBucket(key)
        // 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
        if (buckets[index] != null && buckets[index] != TOMBSTONE) {
            buckets[index] = TOMBSTONE
            size--
        }
    }

    /* 해시 테이블 용량 확장 */
    fun extend() {
        // 원래 해시 테이블을 임시로 저장한다
        val bucketsTmp = buckets
        // 용량을 확장한 새 해시 테이블을 초기화한다
        capacity *= extendRatio
        buckets = arrayOfNulls(capacity)
        size = 0
        // 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
        for (pair in bucketsTmp) {
            if (pair != null && pair != TOMBSTONE) {
                put(pair.key, pair._val)
            }
        }
    }

    /* 해시 테이블 출력 */
    fun print() {
        for (pair in buckets) {
            if (pair == null) {
                println("null")
            } else if (pair == TOMBSTONE) {
                println("TOMESTOME")
            } else {
                println("${pair.key} -> ${pair._val}")
            }
        }
    }
}
### 개방 주소법 해시 테이블 ###
class HashMapOpenAddressing
  TOMBSTONE = Pair.new(-1, '-1') # 삭제 표시

  ### 생성자 ###
  def initialize
    @size = 0 # 키-값 쌍 개수
    @capacity = 4 # 해시 테이블 용량
    @load_thres = 2.0 / 3.0 # 용량 확장을 수행하는 적재율 임계값
    @extend_ratio = 2 # 용량 확장 배수
    @buckets = Array.new(@capacity) # 버킷 배열
  end

  ### 해시 함수 ###
  def hash_func(key)
    key % @capacity
  end

  ### 적재율 ###
  def load_factor
    @size / @capacity
  end

  ### key에 해당하는 버킷 인덱스 탐색 ###
  def find_bucket(key)
    index = hash_func(key)
    first_tombstone = -1
    # 선형 탐사로 탐색하고, 빈 버킷을 만나면 반복문을 종료한다
    while !@buckets[index].nil?
      # key를 만나면 해당 버킷 인덱스를 반환한다
      if @buckets[index].key == key
        # 이전에 삭제 표시를 만났으면 키-값 쌍을 그 인덱스로 옮긴다
        if first_tombstone != -1
          @buckets[first_tombstone] = @buckets[index]
          @buckets[index] = TOMBSTONE
          return first_tombstone # 옮긴 후의 버킷 인덱스를 반환한다
        end
        return index # 버킷 인덱스를 반환한다
      end
      # 처음 만난 삭제 표시를 기록한다
      first_tombstone = index if first_tombstone == -1 && @buckets[index] == TOMBSTONE
      # 버킷 인덱스를 계산하고, 끝을 넘어가면 처음으로 돌아온다
      index = (index + 1) % @capacity
    end
    # key가 없으면 추가할 위치의 인덱스를 반환한다
    first_tombstone == -1 ? index : first_tombstone
  end

  ### 조회 연산 ###
  def get(key)
    # key에 해당하는 버킷 인덱스 탐색
    index = find_bucket(key)
    # 키-값 쌍을 찾으면 해당 val을 반환한다
    return @buckets[index].val unless [nil, TOMBSTONE].include?(@buckets[index])
    # 키-값 쌍이 없으면 nil을 반환한다
    nil
  end

  ### 추가 연산 ###
  def put(key, val)
    # 적재율이 임계값을 초과하면 용량을 확장한다
    extend if load_factor > @load_thres
    # key에 해당하는 버킷 인덱스 탐색
    index = find_bucket(key)
    # 키-값 쌍을 찾으면 val을 덮어쓰고 반환한다
    unless [nil, TOMBSTONE].include?(@buckets[index])
      @buckets[index].val = val
      return
    end
    # 키-값 쌍이 없으면 해당 키-값 쌍을 추가한다
    @buckets[index] = Pair.new(key, val)
    @size += 1
  end

  ### 삭제 연산 ###
  def remove(key)
    # key에 해당하는 버킷 인덱스 탐색
    index = find_bucket(key)
    # 키-값 쌍을 찾으면 삭제 표시로 덮어쓴다
    unless [nil, TOMBSTONE].include?(@buckets[index])
      @buckets[index] = TOMBSTONE
      @size -= 1
    end
  end

  ### 해시 테이블 용량 확장 ###
  def extend
    # 원래 해시 테이블을 임시로 저장한다
    buckets_tmp = @buckets
    # 용량을 확장한 새 해시 테이블을 초기화한다
    @capacity *= @extend_ratio
    @buckets = Array.new(@capacity)
    @size = 0
    # 원래 해시 테이블의 키-값 쌍을 새 해시 테이블로 옮긴다
    for pair in buckets_tmp
      put(pair.key, pair.val) unless [nil, TOMBSTONE].include?(pair)
    end
  end

  ### 해시 테이블 출력 ###
  def print
    for pair in @buckets
      if pair.nil?
        puts "Nil"
      elsif pair == TOMBSTONE
        puts "TOMBSTONE"
      else
        puts "#{pair.key} -> #{pair.val}"
      end
    end
  end
end
2. 이차 탐사
이차 탐사는 선형 탐사처럼 개방 주소법의 대표적인 전략이다. 충돌이 발생하면 고정 간격으로 이동하는 대신 ‘탐사 횟수의 제곱’만큼, 즉 \(1, 4, 9, \dots\)칸을 이동한다.
이차 탐사의 주요 장점은 다음과 같다.
- 탐사 횟수의 제곱만큼 떨어진 위치로 이동하여 선형 탐사의 군집 현상을 완화하려 한다.
- 더 먼 거리로 건너뛰며 빈 위치를 찾으므로 데이터를 더 고르게 분포시키는 데 도움이 된다.
하지만 이차 탐사도 완벽하지는 않다.
- 일부 위치가 다른 위치보다 더 쉽게 채워지는 군집 현상이 여전히 존재한다.
- 제곱의 증가 때문에 해시 테이블 전체를 탐사하지 못할 수 있다. 즉, 빈 버킷이 있어도 그곳에 도달하지 못할 수 있다.
3. 다중 해싱
이름 그대로 여러 해시 함수 \(f_1(x)\), \(f_2(x)\), \(f_3(x)\), \(\dots\)를 사용하여 탐사하는 방법이다.
- 원소 삽입: 해시 함수 \(f_1(x)\)에서 충돌하면 \(f_2(x)\)를 시도한다. 이런 식으로 빈 위치를 찾을 때까지 계속한 뒤 원소를 넣는다.
- 원소 탐색: 같은 해시 함수 순서로 탐색하여 목표 원소를 찾으면 반환한다. 빈 위치를 만나거나 모든 함수를 시도했다면 원소가 없다는 뜻이므로
None을 반환한다.
선형 탐사보다 군집 현상이 덜 발생하지만, 여러 해시 함수로 인해 추가 계산이 필요하다.
참고
개방 주소법의 선형 탐사, 이차 탐사, 다중 해싱 모두 ‘원소를 곧바로 삭제할 수 없다’는 문제가 있다는 점에 주의하자.
6.2.3 프로그래밍 언어의 선택
프로그래밍 언어마다 해시 테이블 구현 전략이 다르다. 몇 가지 예를 살펴보자.
- Python은 개방 주소법을 사용한다. 딕셔너리
dict는 의사 난수를 이용해 탐사한다. - Java는 체이닝을 사용한다. JDK 1.8부터는
HashMap내부 배열 길이가 64 이상이고 연결 리스트 길이가 8 이상이면, 탐색 성능을 높이기 위해 연결 리스트를 레드-블랙 트리로 바꾼다. - Go 1.24부터 내장
map은 기본적으로 Swiss Table 기반의 개방 주소법을 사용한다. Go 1.23 이하에서는 체이닝을 사용하며, 버킷 하나에 키-값 쌍을 최대 8개 저장하고 용량을 넘으면 오버플로 버킷을 연결한다.