10.5 탐색 알고리즘 다시 보기
탐색 알고리즘(searching algorithm)은 배열, 연결 리스트, 트리, 그래프 등의 자료 구조에서 특정 조건을 만족하는 원소 하나 또는 여러 개를 찾는 데 사용한다.
탐색 알고리즘은 구현 아이디어에 따라 다음 두 종류로 나뉜다.
- 배열, 연결 리스트, 트리, 그래프의 순회처럼 자료 구조를 순회하여 목표 원소를 찾는다.
- 이진 탐색, 해시 탐색, 이진 탐색 트리의 탐색처럼 데이터의 구성 방식이나 데이터에 대한 사전 정보를 이용하여 원소를 효율적으로 찾는다.
이 내용은 모두 앞 장들에서 이미 소개했으므로 탐색 알고리즘은 낯설지 않을 것이다. 이 절에서는 더 체계적인 관점에서 탐색 알고리즘을 다시 살펴본다.
10.5.1 완전 탐색
완전 탐색은 자료 구조의 각 원소를 순회하여 목표 원소를 찾는다.
- '선형 탐색'은 배열이나 연결 리스트 같은 선형 자료 구조에 적합하다. 자료 구조의 한쪽 끝에서 원소를 하나씩 방문하며, 목표 원소를 찾거나 찾지 못한 채 반대쪽 끝에 도달하면 종료한다.
- '너비 우선 탐색'과 '깊이 우선 탐색'은 그래프와 트리의 두 가지 순회 전략이다. 너비 우선 탐색은 시작 노드에서 한 층씩 탐색하며 가까운 노드부터 먼 노드 순서로 방문한다. 깊이 우선 탐색은 시작 노드에서 한 경로를 따라 끝까지 간 뒤 되돌아와 다른 경로를 시도하며, 전체 자료 구조를 순회할 때까지 반복한다.
완전 탐색은 간단하고 범용성이 좋으며, 데이터를 전처리하거나 추가 자료 구조를 사용할 필요가 없다.
하지만 이러한 알고리즘의 시간 복잡도는 \(O(n)\)이다. 여기서 \(n\)은 원소 수이며, 데이터가 많으면 성능이 떨어진다.
10.5.2 적응형 탐색
적응형 탐색은 정렬 여부 같은 데이터 고유의 성질을 이용하여 탐색 과정을 최적화하고, 목표 원소를 더 효율적으로 찾는다.
- '이진 탐색'은 데이터의 정렬 상태를 이용하여 효율적으로 찾으며, 배열에만 적합하다.
- '해시 탐색'은 해시 테이블로 탐색 데이터와 목표 데이터 사이에 키-값 매핑을 만들어 조회한다.
- '트리 탐색'은 이진 탐색 트리 같은 특정 트리 구조에서 노드 값을 비교하여 탐색 대상에서 빠르게 제외하고 목표 원소를 찾는다.
이러한 알고리즘은 효율이 높아 시간 복잡도가 \(O(\log n)\), 나아가 \(O(1)\)에 이를 수 있다.
하지만 이런 알고리즘을 사용하려면 데이터를 전처리해야 하는 경우가 많다. 예를 들어 이진 탐색은 배열을 미리 정렬해야 하며, 해시 탐색과 트리 탐색은 추가 자료 구조가 필요하다. 이러한 자료 구조를 유지하는 데도 시간과 공간이 추가로 든다.
참고
적응형 탐색 알고리즘은 조회 알고리즘이라고도 하며, 주로 특정 자료 구조에서 목표 원소를 빠르게 조회하는 데 사용한다.
10.5.3 탐색 방법 선택
크기가 \(n\)인 데이터 집합이 주어지면 선형 탐색, 이진 탐색, 트리 탐색, 해시 탐색 등 다양한 방법으로 목표 원소를 찾을 수 있다. 각 방법의 동작 원리는 아래 그림(10-11)과 같다.
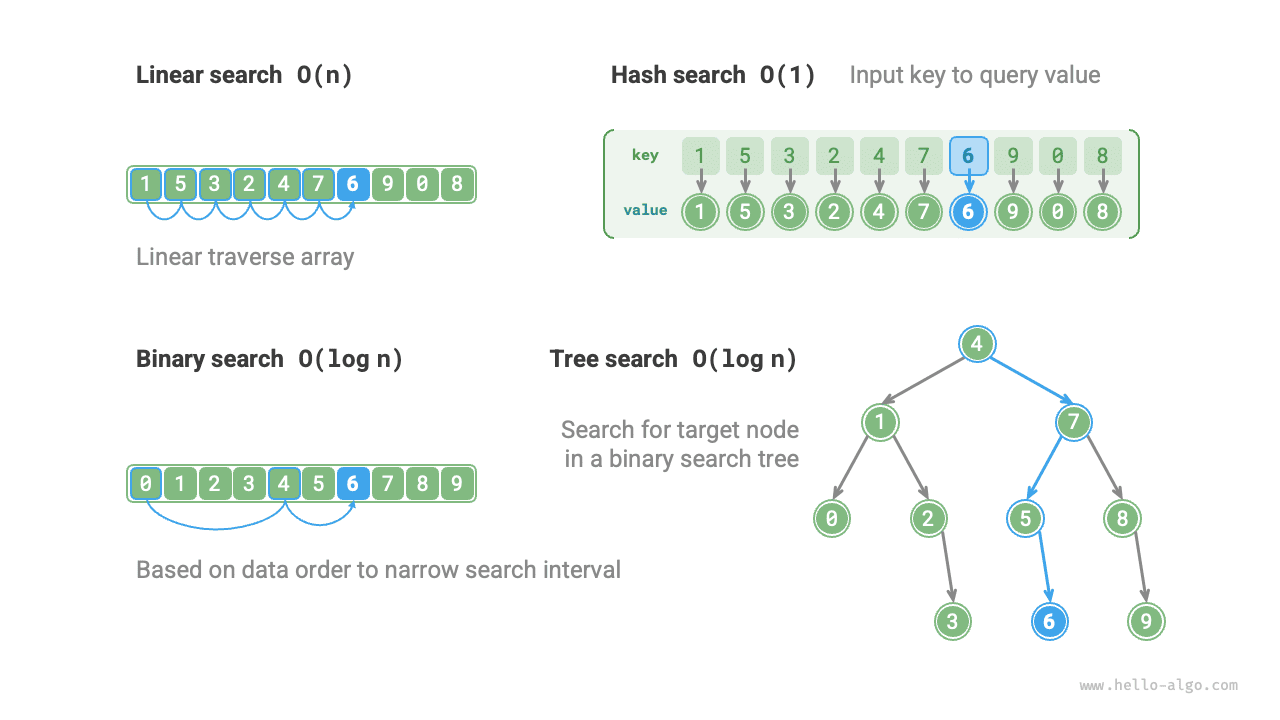
그림 10-11 다양한 탐색 전략
위 방법들의 연산 효율과 특성은 아래 표(10-1)와 같다.
표 10-1 탐색 알고리즘 효율 비교
| 선형 탐색 | 이진 탐색 | 트리 탐색 | 해시 탐색 | |
|---|---|---|---|---|
| 원소 탐색 | \(O(n)\) | \(O(\log n)\) | \(O(\log n)\) | \(O(1)\) |
| 원소 삽입 | \(O(1)\) | \(O(n)\) | \(O(\log n)\) | \(O(1)\) |
| 원소 삭제 | \(O(n)\) | \(O(n)\) | \(O(\log n)\) | \(O(1)\) |
| 추가 공간 | \(O(1)\) | \(O(1)\) | \(O(n)\) | \(O(n)\) |
| 데이터 전처리 | / | 정렬 \(O(n \log n)\) | 트리 구성 \(O(n \log n)\) | 해시 테이블 구성 \(O(n)\) |
| 데이터 정렬 여부 | 정렬되지 않음 | 정렬됨 | 정렬됨 | 정렬되지 않음 |
탐색 알고리즘을 선택할 때는 데이터 규모, 요구되는 탐색 성능, 데이터 조회와 갱신 빈도 등도 고려해야 한다.
선형 탐색
- 범용성이 좋으며 데이터 전처리가 전혀 필요하지 않다. 데이터를 한 번만 조회한다면 나머지 세 방법은 전처리 시간만으로도 선형 탐색보다 오래 걸린다.
- 데이터 규모가 작을 때 적합하다. 이때는 시간 복잡도가 효율에 미치는 영향이 작다.
- 데이터를 추가로 관리할 필요가 없으므로 데이터 갱신이 잦은 상황에 적합하다.
이진 탐색
- 데이터가 많을 때 적합하며, 최악의 시간 복잡도가 \(O(\log n)\)으로 성능이 안정적이다.
- 배열을 저장하려면 연속된 메모리 공간이 필요하므로 데이터가 지나치게 많으면 안 된다.
- 정렬된 배열을 유지하는 비용이 크므로 데이터 추가와 삭제가 잦은 상황에는 적합하지 않다.
해시 탐색
- 평균 시간 복잡도가 \(O(1)\)이므로 매우 높은 조회 성능이 필요한 상황에 적합하다.
- 해시 테이블은 데이터의 정렬 상태를 유지할 수 없으므로 정렬된 데이터나 범위 탐색이 필요한 상황에는 적합하지 않다.
- 해시 함수와 해시 충돌 처리 전략에 크게 의존하므로 성능이 저하될 위험이 비교적 크다.
- 충돌을 최대한 줄여 좋은 조회 성능을 내려면 추가 공간이 필요하므로 데이터가 지나치게 많은 경우에는 적합하지 않다.
트리 탐색
- 트리 노드는 메모리에 분산 저장되므로 대규모 데이터에 적합하다.
- 데이터의 정렬 상태를 유지하거나 범위 탐색을 해야 하는 상황에 적합하다.
- 노드를 계속 추가하고 삭제하다 보면 이진 탐색 트리가 한쪽으로 치우쳐 시간 복잡도가 \(O(n)\)으로 저하될 수 있다.
- AVL 트리나 레드-블랙 트리를 사용하면 각 연산을 안정적으로 \(O(\log n)\)에 수행할 수 있지만, 트리의 균형을 유지하는 데 추가 비용이 든다.